Micron desarrolla memoria de inferencia en el borde para aplicaciones de IA físicas
Micron está avanzando en el desarrollo de un chip de almacenamiento especializado para aplicaciones de IA físicas, llamado Memoria de Inferencia en el Borde (EIM). En un foro de semiconductores en Seúl durante SEDEX 2026, el ejecutivo de Micron, Lee Jeok, destacó el rápido crecimiento de mercados como la conducción autónoma, los robots humanoides y la realidad aumentada/virtual (AR/VR), y señaló la colaboración de la empresa con clientes clave para desarrollar productos adaptados a estas áreas. EIM está diseñado para procesar datos de inferencia de IA de forma rápida, apilando memoria de bajo consumo sobre chips lógicos, a diferencia de la computación en memoria (PIM) en arquitectura, pero compartiendo el objetivo de mejorar la eficiencia de los datos. Micron aún no ha divulgado las métricas de rendimiento de EIM, pero está trabajando en integrarlo con LPDDR6. Los expertos de la industria predicen la producción en masa a finales de 2028. Los robots humanoides, que requieren un procesamiento de datos en tiempo real y la capacidad de tomar decisiones, necesitan un ancho de banda de memoria más alto que los robots industriales tradicionales. Actualmente, dependen de la memoria LPDDR, pero a medida que los modelos de IA se vuelven más complejos, Micron predice un cambio hacia la memoria de alto ancho de banda (HBM). Lee Jeok señaló que, si bien los modelos actuales utilizan entre 1B y 2B parámetros, los futuros modelos de lenguaje visual requerirán HBM. Micron también anticipa la necesidad de 200 GB de DRAM y 4 TB de almacenamiento en robots humanoides avanzados, en comparación con 12 GB de DRAM y 256 GB de almacenamiento en los modelos actuales. La empresa está colaborando con fabricantes de robots, diseñadores de chips y proveedores de la nube para dar forma a los diseños iniciales de sistemas para la IA física.
OpenAI avanza en robótica humanoide con enfoque en el 'cerebro' de IA
OpenAI, dirigida por el CEO Sam Altman, está avanzando en su proyecto de robots humanoides, enfatizando el desarrollo de un 'cerebro' de IA en lugar del diseño físico. Altman afirmó que la forma humanoide es lógica, ya que el mundo está diseñado para los humanos, con herramientas y entornos moldeados alrededor de la anatomía humana. Destacó que la prioridad es crear un 'cerebro' que permita al robot utilizar sus extremidades de manera efectiva, en lugar de centrarse en la estética. OpenAI planea presentar un prototipo en 2027, pero espera que la implementación completa tarde varios años. El proyecto implica tareas complejas como la manipulación de objetos y la adaptación al entorno, lo que requiere un aprendizaje automático y experiencia en robótica avanzados. OpenAI está contratando en múltiples áreas, incluyendo el control del movimiento y el desarrollo de hardware, y ya ha logrado avances con proyectos como Dactyl, que ha entrenado manos robóticas en entornos simulados. Si bien competidores como Tesla y Xiaopeng han desarrollado robots humanoides, el enfoque de OpenAI sigue siendo la integración de la IA y las aplicaciones prácticas, como el apoyo a la infraestructura y la asistencia personal, sin que se haya anunciado aún ningún precio de venta o fecha de lanzamiento.
Lenovo presenta el host p7 impulsado por IA con combinación de chips personalizada
Lenovo anunció el 18 de octubre que lanzará el Host P7 impulsado por IA el 24 de octubre, durante un evento especial en Changsha, China. El dispositivo estará disponible para pre-orden el mismo día. El P7 está impulsado por una combinación de chips personalizada de Zhixin Technology y Houmo Intelligence, que incluye el SoC P1 y el dNPU M50. Esta configuración proporciona 190TOPS de potencia de cálculo de IA local, lo que permite la implementación de modelos LLM de 122B con una ventana de contexto de 128K y una tasa de inferencia local de 50TPS. El lanzamiento sigue a un anuncio realizado en mayo, en el que Lenovo detalló las especificaciones técnicas del P7. El Host P7 impulsado por IA está posicionado como un dispositivo de alto rendimiento para desarrolladores y entusiastas de la IA, aprovechando los últimos avances en la tecnología de chips de IA.
Kyutai presenta REKI: un modelo vla de 2.4B que mejora la manipulación robótica con memoria eficiente
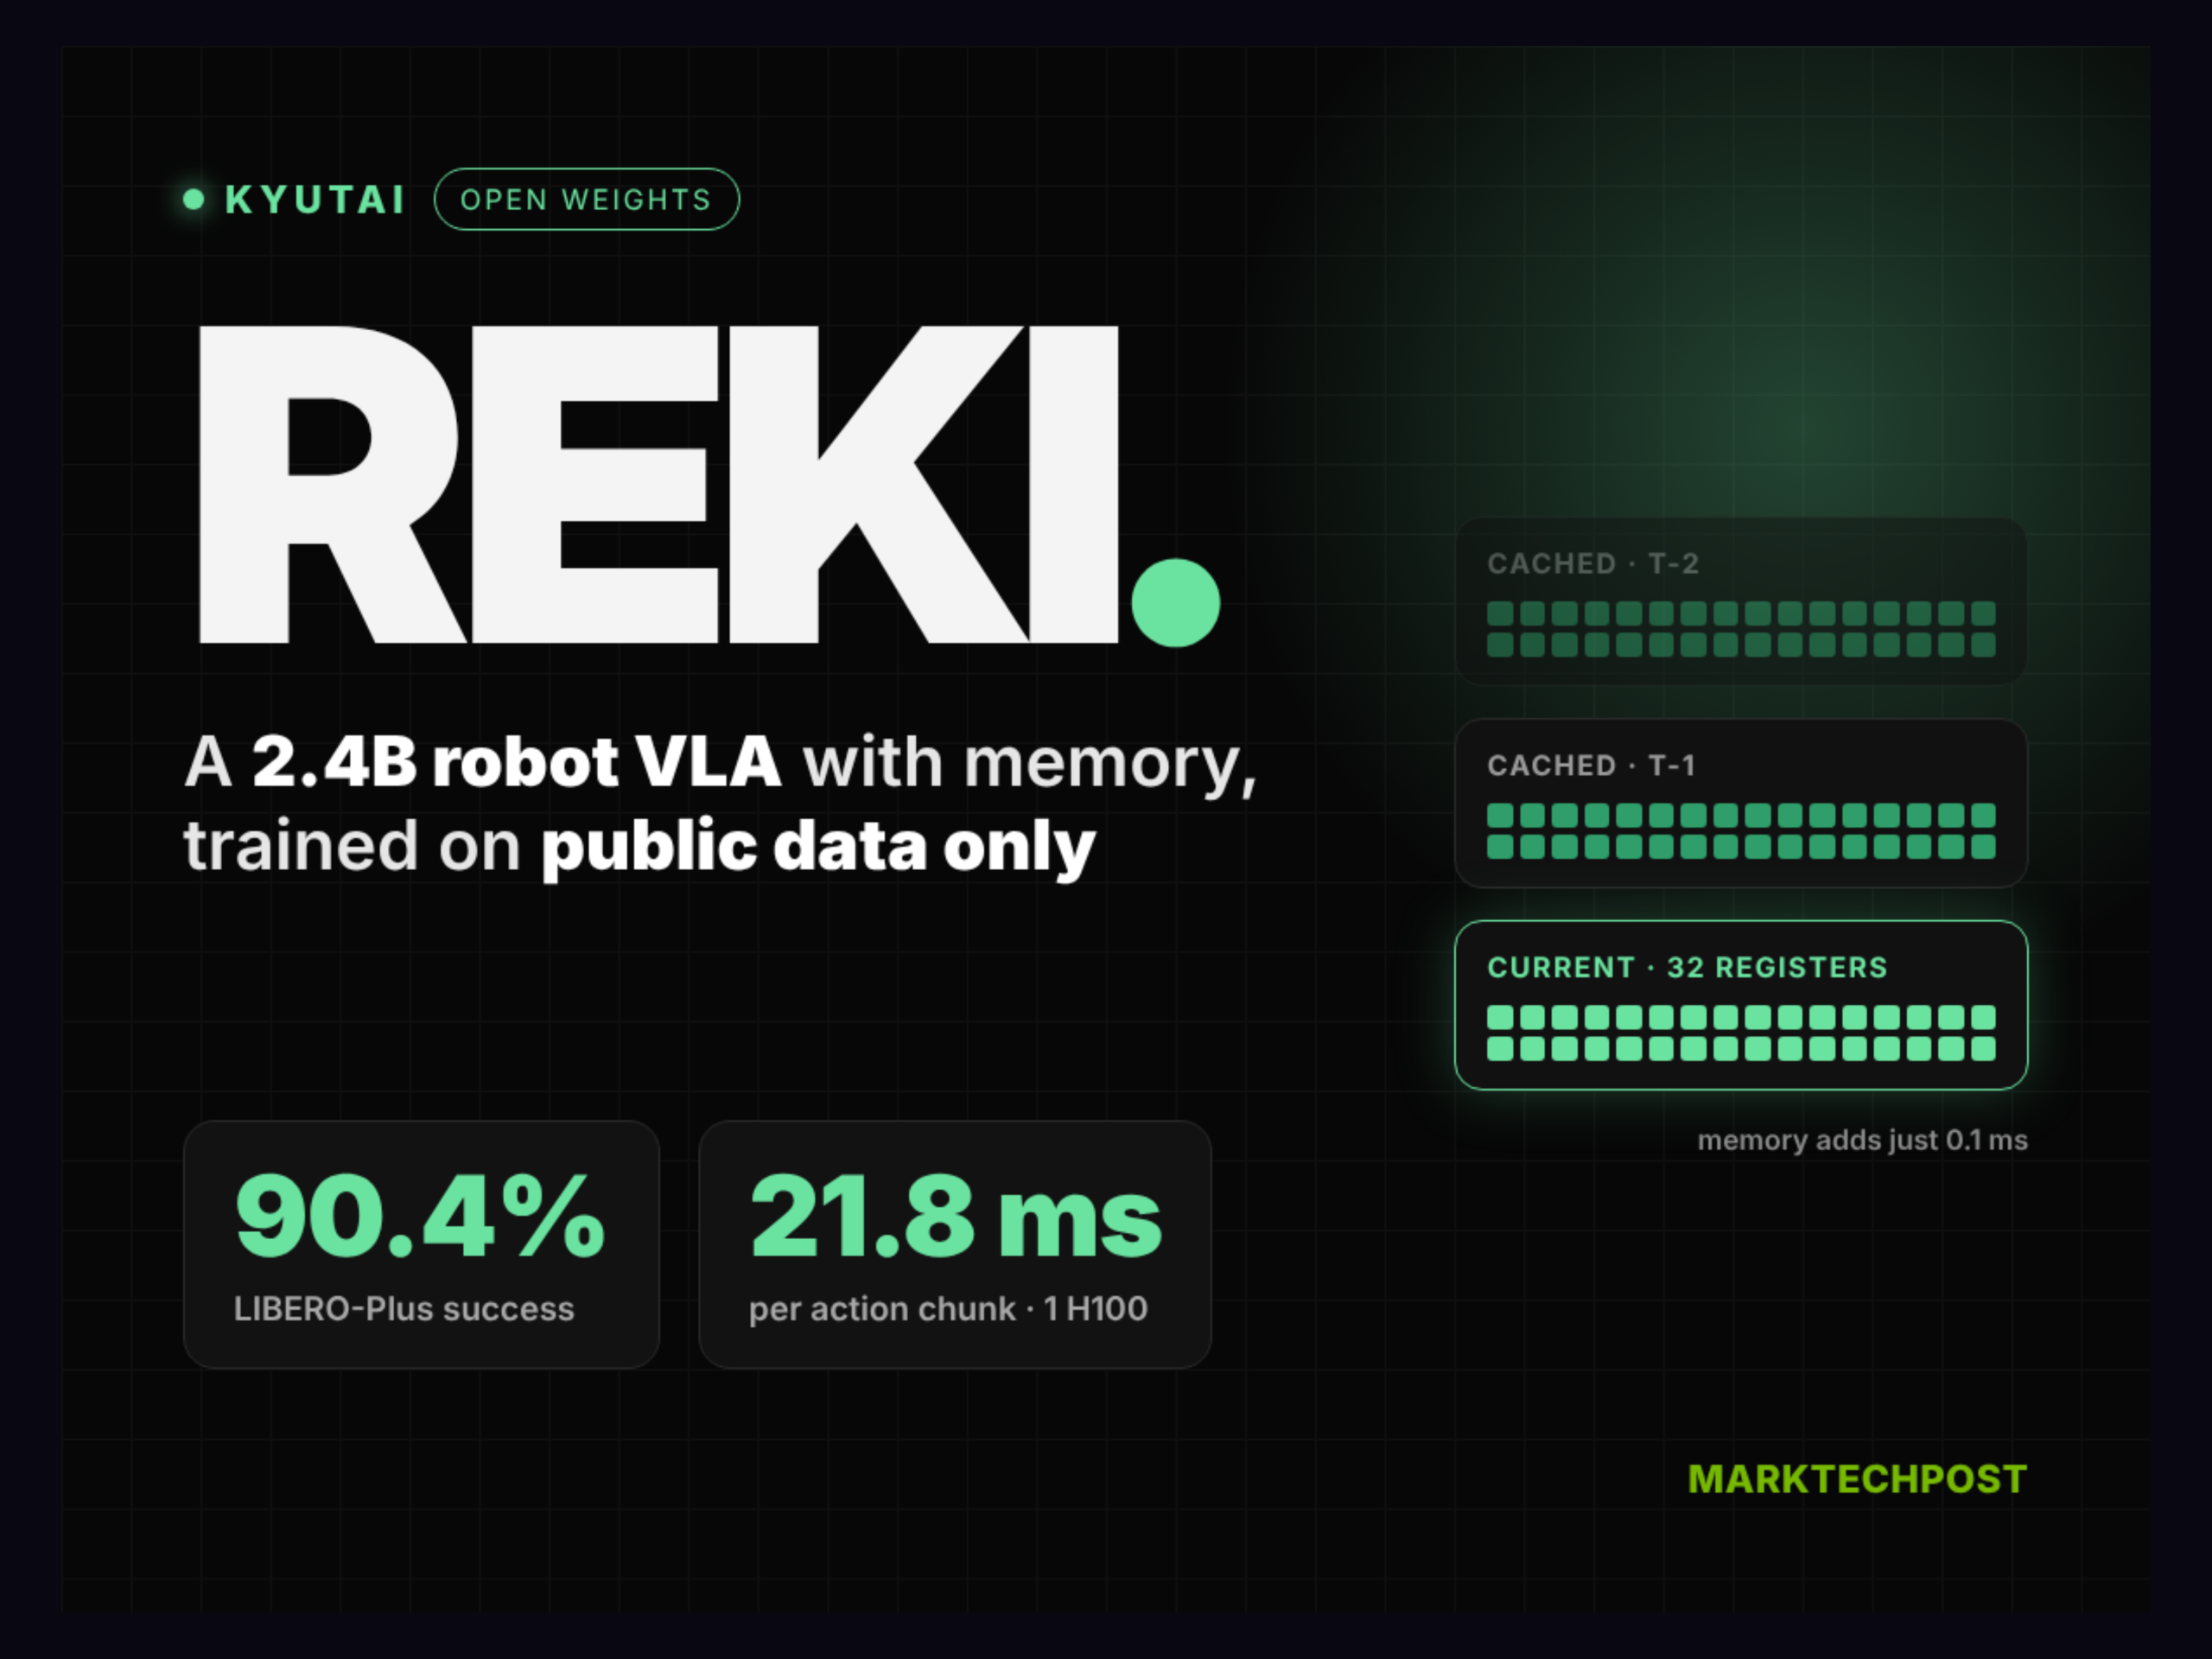
Kyutai, en colaboración con Inria y École des Ponts, ha presentado REKI, un modelo de visión-lenguaje-acción (VLA) de 2.4B diseñado para mejorar la manipulación robótica. REKI ha sido preentrenado con datos públicos y cuenta con un sistema de memoria de bajo coste que retiene información reciente. Supera a modelos de tamaño similar en tres pruebas fuera del dominio, siendo solo los modelos más grandes los que lo superan. Todos los pesos del modelo están ahora disponibles en Hugging Face. REKI integra una arquitectura Qwen3.5-2B con un experto de acción de 200M parámetros, generando fragmentos de acción a través de la correspondencia de flujo en 10 pasos de Euler. El modelo utiliza RMSNorm adaptativo para el estado y el tiempo del flujo, con cada disposición de estado teniendo su propio pequeño MLP de estado. A diferencia de la mayoría de los VLAs que se basan únicamente en el fotograma actual, REKI integra la memoria dentro del experto de acción, utilizando 32 tokens de registro aprendidos que cruzan la atención de las indicaciones y las vistas codificadas, así como la atención de auto-referencia a fotogramas anteriores. Este diseño reduce la oscilación en los brazos robóticos, reduciendo las tasas de fallo en RoboTwin de 18,6 % a 4,1 %. El preentrenamiento mejora significativamente el rendimiento, añadiendo 13,8 puntos en Clean2Rand y 30,3 en cluttered. La memoria mejora aún más los resultados, añadiendo 1,5 puntos en LIBERO-Plus y 5,4 en RoboCasa365. El modelo se preentrena una vez y se ajusta para cada prueba, con seis puntos de control disponibles, incluyendo versiones para LIBERO, RoboTwin, RoboCasa365 y RoboCasa-GR1. REKI está optimizado para el despliegue en robots reales utilizando el protocolo LeRobot, con un ajuste fino en un brazo UR5 que requiere 3.000 pasos en una hora.
Anthropic elimina haiku 4.5 de los modelos públicos
Anthropic anunció el 15 de octubre de 2026 que Haiku 4.5 será eliminado de los planes Free, Pro y Max a partir del 29 de octubre de 2026. El cambio afecta a todas las plataformas, incluyendo web, escritorio y móvil, así como a funciones como Claude Cowork y Claude Design. Los usuarios aún pueden acceder a Haiku 4.5 a través de la sección 'Más modelos' hasta el 29 de octubre, después del cual ya no aparecerá en el selector de modelos. Si los usuarios están utilizando actualmente Haiku 4.5, el sistema los cambiará automáticamente a Haiku 5.5. La actualización no afecta la disponibilidad de Haiku 4.5 en los planes Claude Code, Team, Enterprise o a través de la API de Anthropic. Las conversaciones existentes de Haiku 4.5 permanecerán intactas, y los usuarios podrán seguir interactuando con ellas utilizando Haiku 5.5 a partir del 29 de octubre. También podrán exportar sus datos de chat si es necesario. Haiku 5.5, lanzado el 7 de octubre de 2026, es el primer modelo de la serie que permite ajustar los niveles de pensamiento, con una ventana de contexto de 1 millón de tokens y una salida máxima de 128K tokens. Muestra mejoras significativas en tareas de codificación y de agentes en comparación con Haiku 4.5. Anthropic señaló que el coste medio de ejecutar Haiku 5.5 es aproximadamente un 75% inferior a Haiku 4.5, con una reducción de costes del 90% para las indicaciones de menos de 100.000 tokens, lo que cubre aproximadamente el 90% de todas las solicitudes de la serie.
China lanza el primer sistema de pronóstico meteorológico basado en IA totalmente autónomo
China ha desplegado su primer sistema de pronóstico meteorológico basado en IA totalmente autónomo, 'Fengqing', que ya está operativo en todo el país. Desarrollado por el Centro Nacional de Meteorología en colaboración con varias universidades e instituciones de investigación, el sistema aprovecha el Centro Nacional de Supercomputación de la agrupación de supercomputación AI4S en Tianjin. Es el primer sistema en China que logra el control total de los datos, los modelos y la potencia de cálculo, lo que supone un importante avance en la tecnología de la IA meteorológica. Fengqing utiliza una arquitectura de Transformer visual combinada con restricciones de física meteorológica para mejorar la precisión de los pronósticos para eventos meteorológicos extremos como los tifones y las fuertes lluvias. El sistema puede predecir las condiciones meteorológicas con hasta 11 días de antelación, superando a los últimos sistemas de pronóstico basados en IA del Centro Europeo de Pronósticos a Medio Plazo (ECMWF) en varias métricas clave. También permite simulaciones meteorológicas globales rápidas, mejorando la capacidad de predecir tendencias meteorológicas a largo plazo y eventos extremos. El sistema apoyará a diversos sectores, incluyendo la prevención de desastres, el transporte, la gestión de la energía y los servicios públicos. La continua inversión de Tianjin en supercomputación e IA ha hecho posible este avance, que se espera que fortalezca las capacidades de China en la innovación meteorológica y en los pronósticos globales del tiempo.
DeepSeek lanza la versión V4.1-Flash-1017 con un rendimiento y costes mejorados
El 17 de octubre de 2026, DeepSeek anunció el lanzamiento de su versión V4.1-Flash-1017, actualizando sus modelos oficiales del sitio web, la aplicación y la API. La nueva versión logra una mejora de Pareto en rendimiento y eficiencia de costes, con capacidades de modelo mejoradas y tiempos de ejecución de tareas y longitud de salida reducidos, lo que se traduce en costes generales más bajos por llamada. DeepSeek destacó que el nuevo modelo permite a los usuarios completar tareas de forma más eficiente y a un coste menor, alcanzando nuevos puntos Pareto óptimos en rendimiento y coste en múltiples plataformas. La actualización también incluye optimizaciones para DeepSeek Harness, Tencent CodeBuddy y WorkBuddy, con recomendaciones para que los usuarios actualicen a la versión 0.2.1-rc.1 o superior para beneficiarse plenamente de las mejoras. Además, la versión V4.1-Flash-1017 introduce capacidades mejoradas de creación de proyectos en tiempo real a través del aprendizaje por refuerzo con retroalimentación, que admiten escenarios como el desarrollo de juegos y la modelización 3D. DeepSeek afirma que esto permite que el modelo satisfaga las solicitudes de programación basadas en 'deseos', generando proyectos ejecutables con una entrada mínima. Los pesos del modelo ya están disponibles para descargar en HuggingFace y ModelScope, continuando con la estrategia de código abierto bajo la licencia MIT.
China lanza la primera plataforma de interconexión de agentes basada en redes deterministas
El 16 de octubre de 2026, la décima Conferencia de Desarrollo de Redes Futuras en Nanjing marcó el lanzamiento oficial de AXP, la primera plataforma de la industria basada en redes deterministas para la interconexión de agentes. Desarrollada por el Laboratorio de Purple Mountain en colaboración con China Mobile, Jiangsu Future Network Group y Jiangsu Future Network Innovation Research Institute, AXP admite hasta un millón de registros de agentes y 100.000 agentes que funcionan simultáneamente. La plataforma permite la integración perfecta de redes de computación inteligente, la conversión de protocolos y la detección rápida de fallos con tiempos de respuesta de subsegundos. AXP, aprovechando el Centro de Pruebas de Redes Futuras Nacional (CENI), permite el acceso preciso a través de dominios a través de 4.000 kilómetros, reduciendo el tiempo de ejecución de las tareas de extremo a extremo en más del 20%. La plataforma se encuentra actualmente en pruebas en varios escenarios con operadores de telecomunicaciones, proveedores de equipos y grandes fabricantes de acero. Este hito representa un importante avance tecnológico en la infraestructura de internet de agentes inteligentes de China, ofreciendo un sólido soporte de red para la colaboración de IA entre dominios y su despliegue a gran escala.
Microsoft y carnegie mellon lanzan PRAISE para guiar a los programadores junior en la era de la IA
Microsoft y la Universidad Carnegie Mellon han lanzado la iniciativa PRAISE, un programa de mentoría diseñado para guiar a los programadores junior en una era en la que la IA puede generar código rápidamente y participar en el diseño de sistemas. El proyecto, inspirado en la mentoría clínica en la atención médica, empareja a ingenieros en sus primeros años con mentores experimentados para fomentar el pensamiento sistémico, el juicio y la responsabilidad. La iniciativa enfatiza que la IA cambia la naturaleza del trabajo, no la responsabilidad de la calidad y la seguridad del software. Microsoft argumenta que los ingenieros deben seguir entendiendo la lógica subyacente del código para diagnosticar y solucionar los fallos del sistema. Carnegie Mellon proporcionará cursos formales y debates grupales para conectar la teoría de la informática con el desarrollo de software en el mundo real. Michael Hilton, profesor de la universidad, señaló que el modelo tradicional de adquisición de habilidades a través de tareas repetitivas ya no es suficiente, y se necesita un nuevo enfoque para preparar a los ingenieros junior para el futuro impulsado por la IA. El programa PRAISE tiene como objetivo garantizar que los programadores junior desarrollen habilidades críticas como el juicio y la responsabilidad de ingeniería, en lugar de simplemente imitar el comportamiento de la IA. Busca equilibrar la integración de las herramientas de IA con la necesidad de supervisión y experiencia humana. Al combinar la rigurosidad académica con la práctica industrial, la iniciativa espera crear un camino sostenible para la próxima generación de ingenieros de software en un campo cada vez más automatizado.
JetBrains lanza junie local con soporte para nvidia rtx spark, alcanzando 55 tokens por segundo
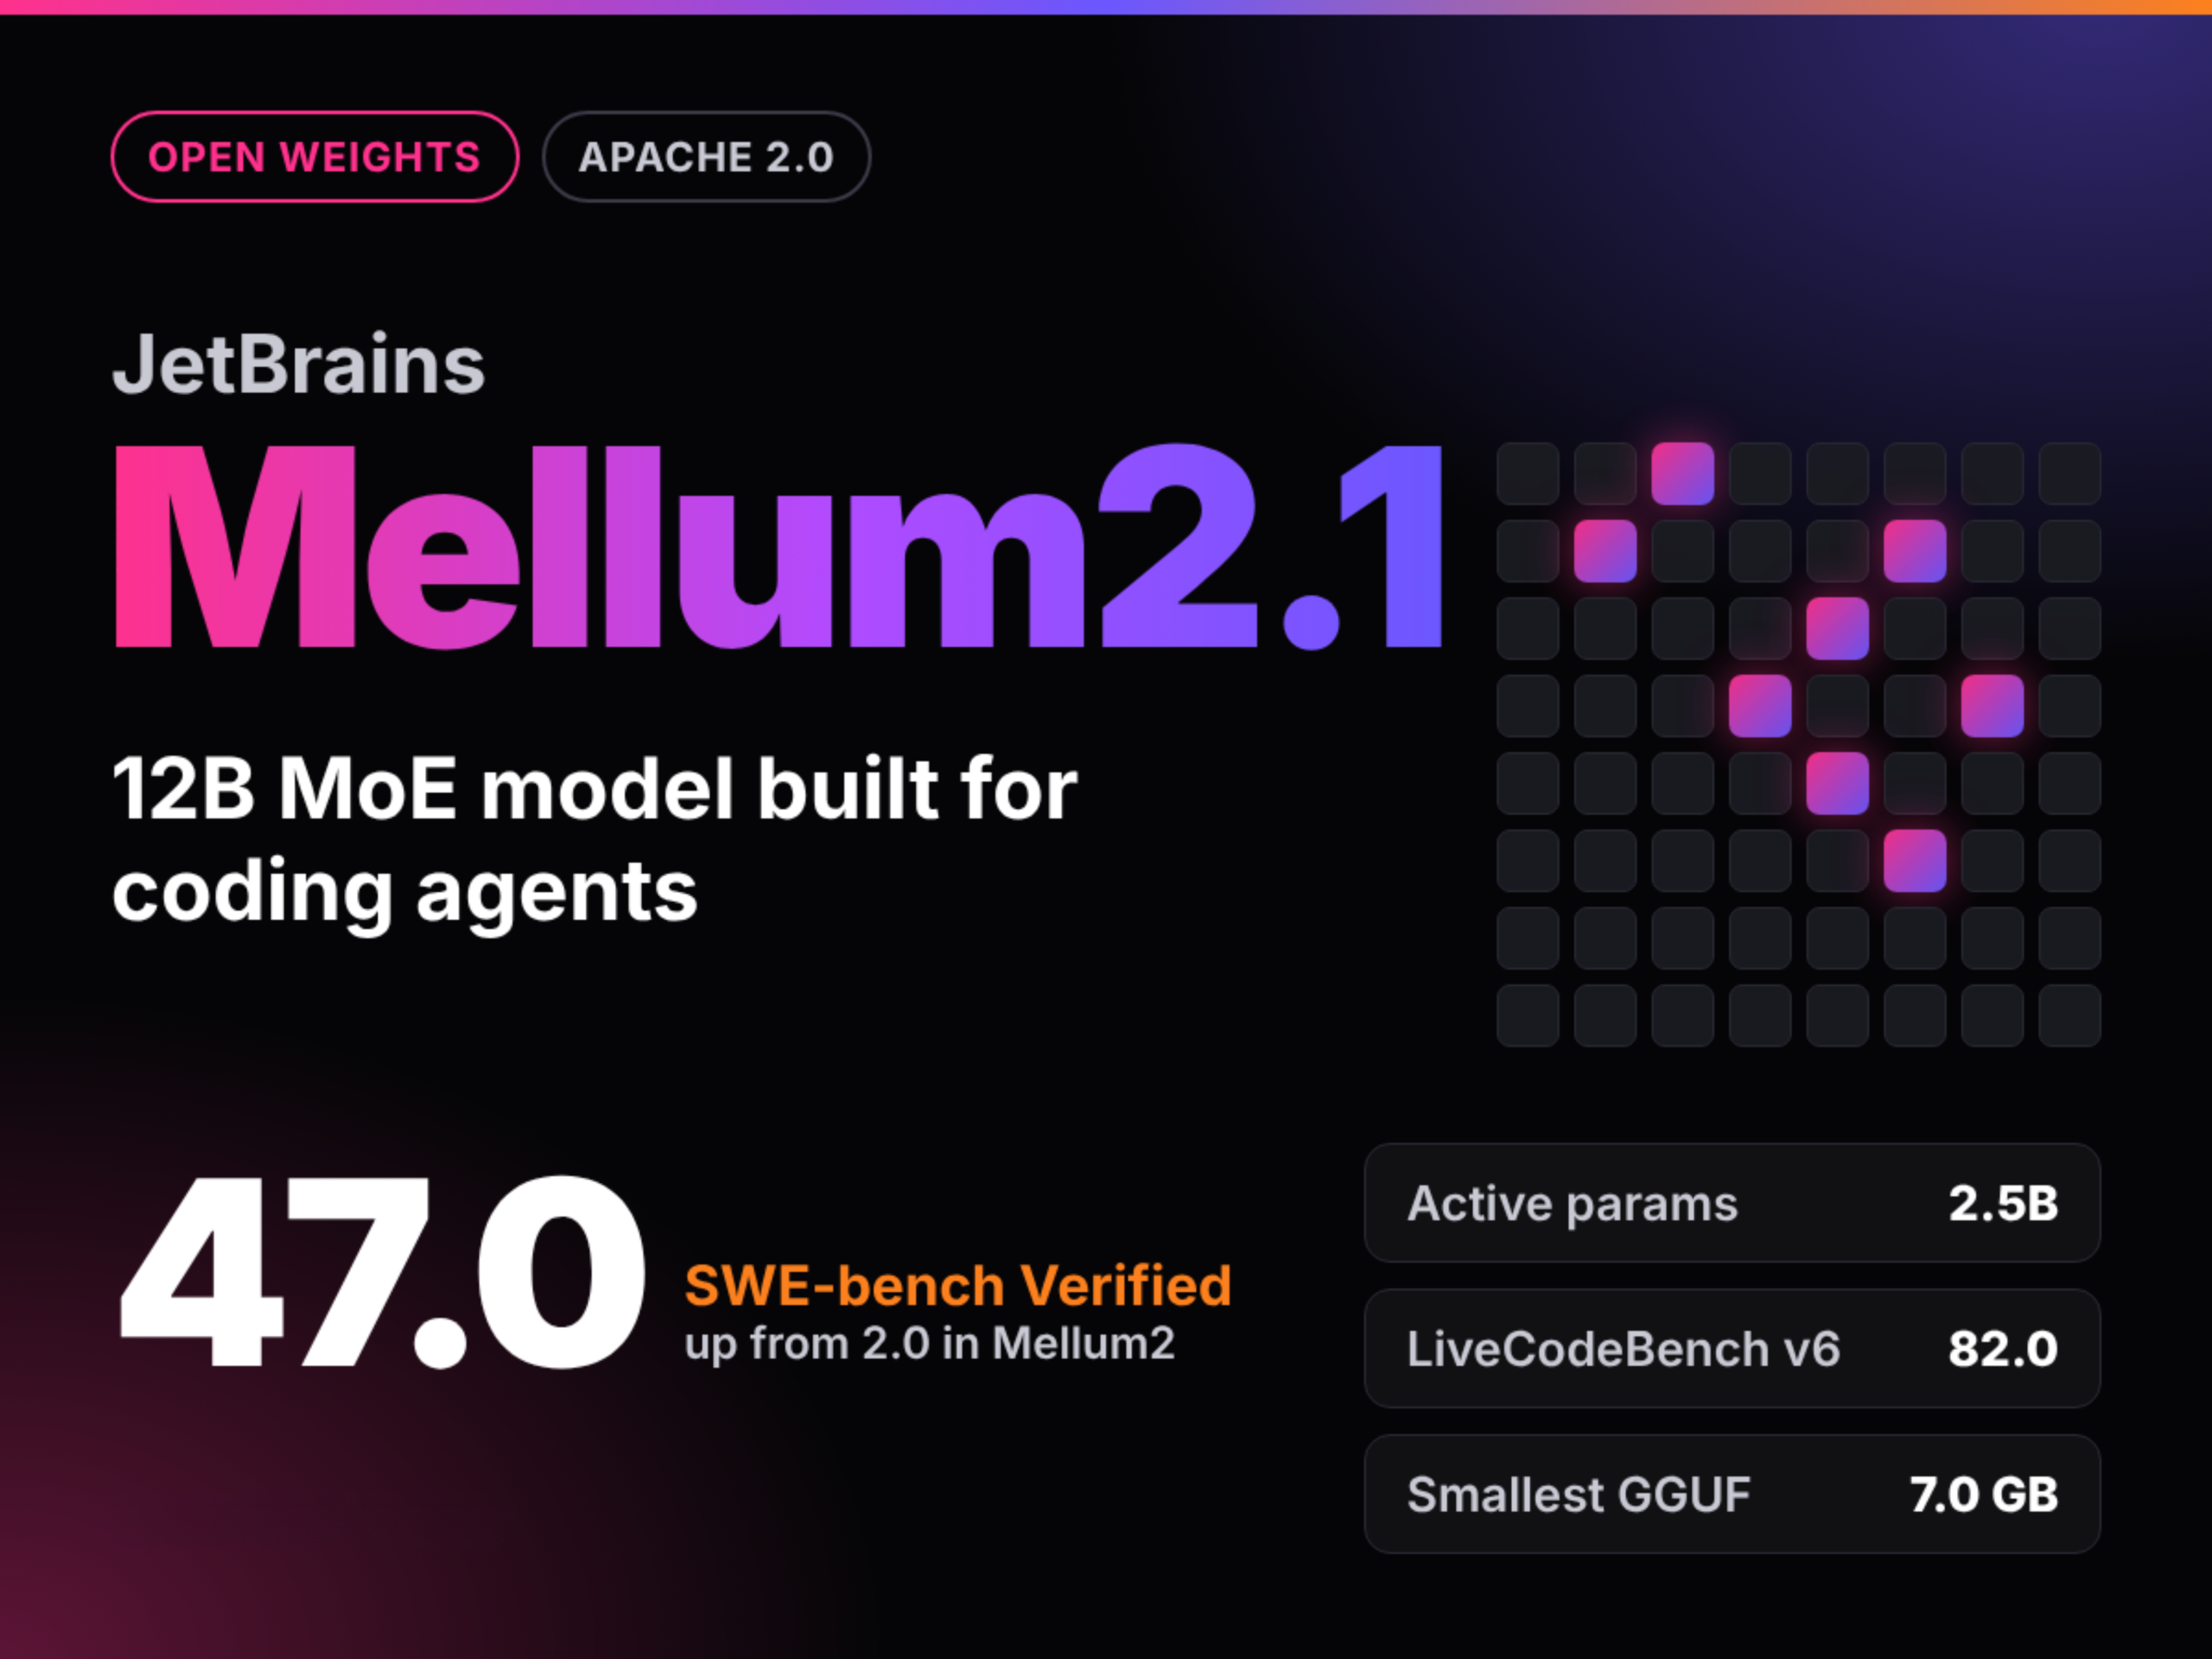
JetBrains ha anunciado que su herramienta de programación de IA local, Junie Local, es ahora compatible con la plataforma NVIDIA RTX Spark desde el día 0. La actualización también marca la transición del soporte de Windows de experimental a estable. Los usuarios ahora pueden ejecutar la herramienta en hardware compatible, lo que permite a la IA leer, modificar y ejecutar código sin necesidad de subir datos a la nube. La herramienta es gratuita de usar, sin necesidad de registro, suscripción o costes de tokens. En pruebas de rendimiento, Junie Local alcanzó un rendimiento máximo de 55 tokens por segundo en la plataforma RTX Spark. Los requisitos de hardware se han ampliado para incluir las GPU RTX 3090, 4090 y 5090 con al menos 24 GB de VRAM, junto con Windows 11 y los controladores NVIDIA actualizados. La nueva versión de Junie Local comprueba automáticamente las GPU y los controladores compatibles, despliega modelos y ajusta la capacidad del contexto en función de la memoria de la GPU disponible. Los usuarios pueden elegir entre Qwen3.6-27B o un modelo proporcionado por JetBrains. La herramienta está diseñada para retener más código e historial de conversación, mejorando la capacidad de la IA para ayudar con tareas de programación complejas.
El objetivo de Hagglebot de elon Musk es aumentar la eficiencia de costes corporativos en más del 5%
Elon Musk, la persona más rica del mundo, anunció el 17 de octubre de 2026 a través de X que su equipo está desarrollando una herramienta de negociación de IA especializada llamada Hagglebot para uso empresarial. El software de IA, diseñado para ayudar a las empresas a obtener mejores acuerdos, se presenta como un 'negociador de adquisiciones digital' que puede ayudar en las negociaciones de precios basadas en presupuestos y términos definidos por el usuario. Musk estima que la herramienta podría aumentar la eficiencia de costes corporativos en un 5% o más, lo que podría ahorrar hasta 6 billones de dólares al año a nivel mundial si se aplicara a toda la escala del PIB. El anuncio se produjo tras una publicación de un usuario que destacaba que Hagglebot ya había ahorrado más de 100.000 dólares para un equipo en su primera semana de funcionamiento. Aunque la herramienta se centra en la negociación comercial en lugar de en funciones de chat generales, los detalles sobre sus estrategias de negociación, las transacciones admitidas, el cronograma de lanzamiento, los precios y la disponibilidad siguen sin ser públicos.
Intel anuncia planes para el procesador 'razor lake ax' para la IA física en 2028
El vicepresidente senior de Intel, Jo Min-sung, anunció en la conferencia 'Robots Humanoides Impulsados por Semiconductores' en Corea del Sur que la empresa planea lanzar el procesador 'Nova Lake' para el sector de la IA física a principios de 2027. A continuación, Intel tiene previsto lanzar el 'Razor Lake AX' en 2028, que ofrecerá una plataforma con una potencia de cómputo total de 700 TOPS, superando significativamente los 180 TOPS del 'Panther Lake'. El 'Razor Lake AX' será el primer SoC de GPU de gran memoria y gran núcleo comercializado de Intel. Utilizará la arquitectura de núcleo estándar 'Nova Lake' al tiempo que integra 16 o 32 núcleos Xe3P, mejorando tanto las capacidades de visualización gráfica como de inferencia de IA. Esto representa un importante paso adelante en la estrategia de Intel para las aplicaciones de IA física.
OpenAI aborda los límites de capacidad del modelo con mejoras del sistema y mayor potencia de cálculo
El 16 de octubre de 2026, IT Home informó que el líder de Codex/ChatGPT de OpenAI, @thsottiaux, anunció en X que el equipo había implementado una serie de actualizaciones y había aumentado la potencia de cálculo para abordar el error de 'límite de capacidad del modelo'. Los cambios formaban parte del plan de entrega continua de 28 días de OpenAI, y la 11ª actualización destacaba las mejoras y los recursos adicionales destinados a reducir la frecuencia del error. Los usuarios han informado que el problema no siempre se debe a que el modelo está completamente utilizado. Algunos usuarios con límites de suscripción y cambios de modelo suficientes aún han experimentado el error repetidamente, mientras que los desarrolladores sospechan que podría estar relacionado con las solicitudes del backend, los estados de sesión o la programación de recursos. El equipo de OpenAI ha optimizado el sistema y ha aumentado la potencia de cálculo para reducir la ocurrencia del error. Si el error persiste, las tareas ahora deberían continuar automáticamente en lugar de quedarse atascadas en un estado de error. El equipo también ha invitado a los usuarios que aún están experimentando el problema a proporcionar comentarios para una mayor investigación.
Perplexity lanza un sandbox de código abierto para la seguridad de los agentes de IA
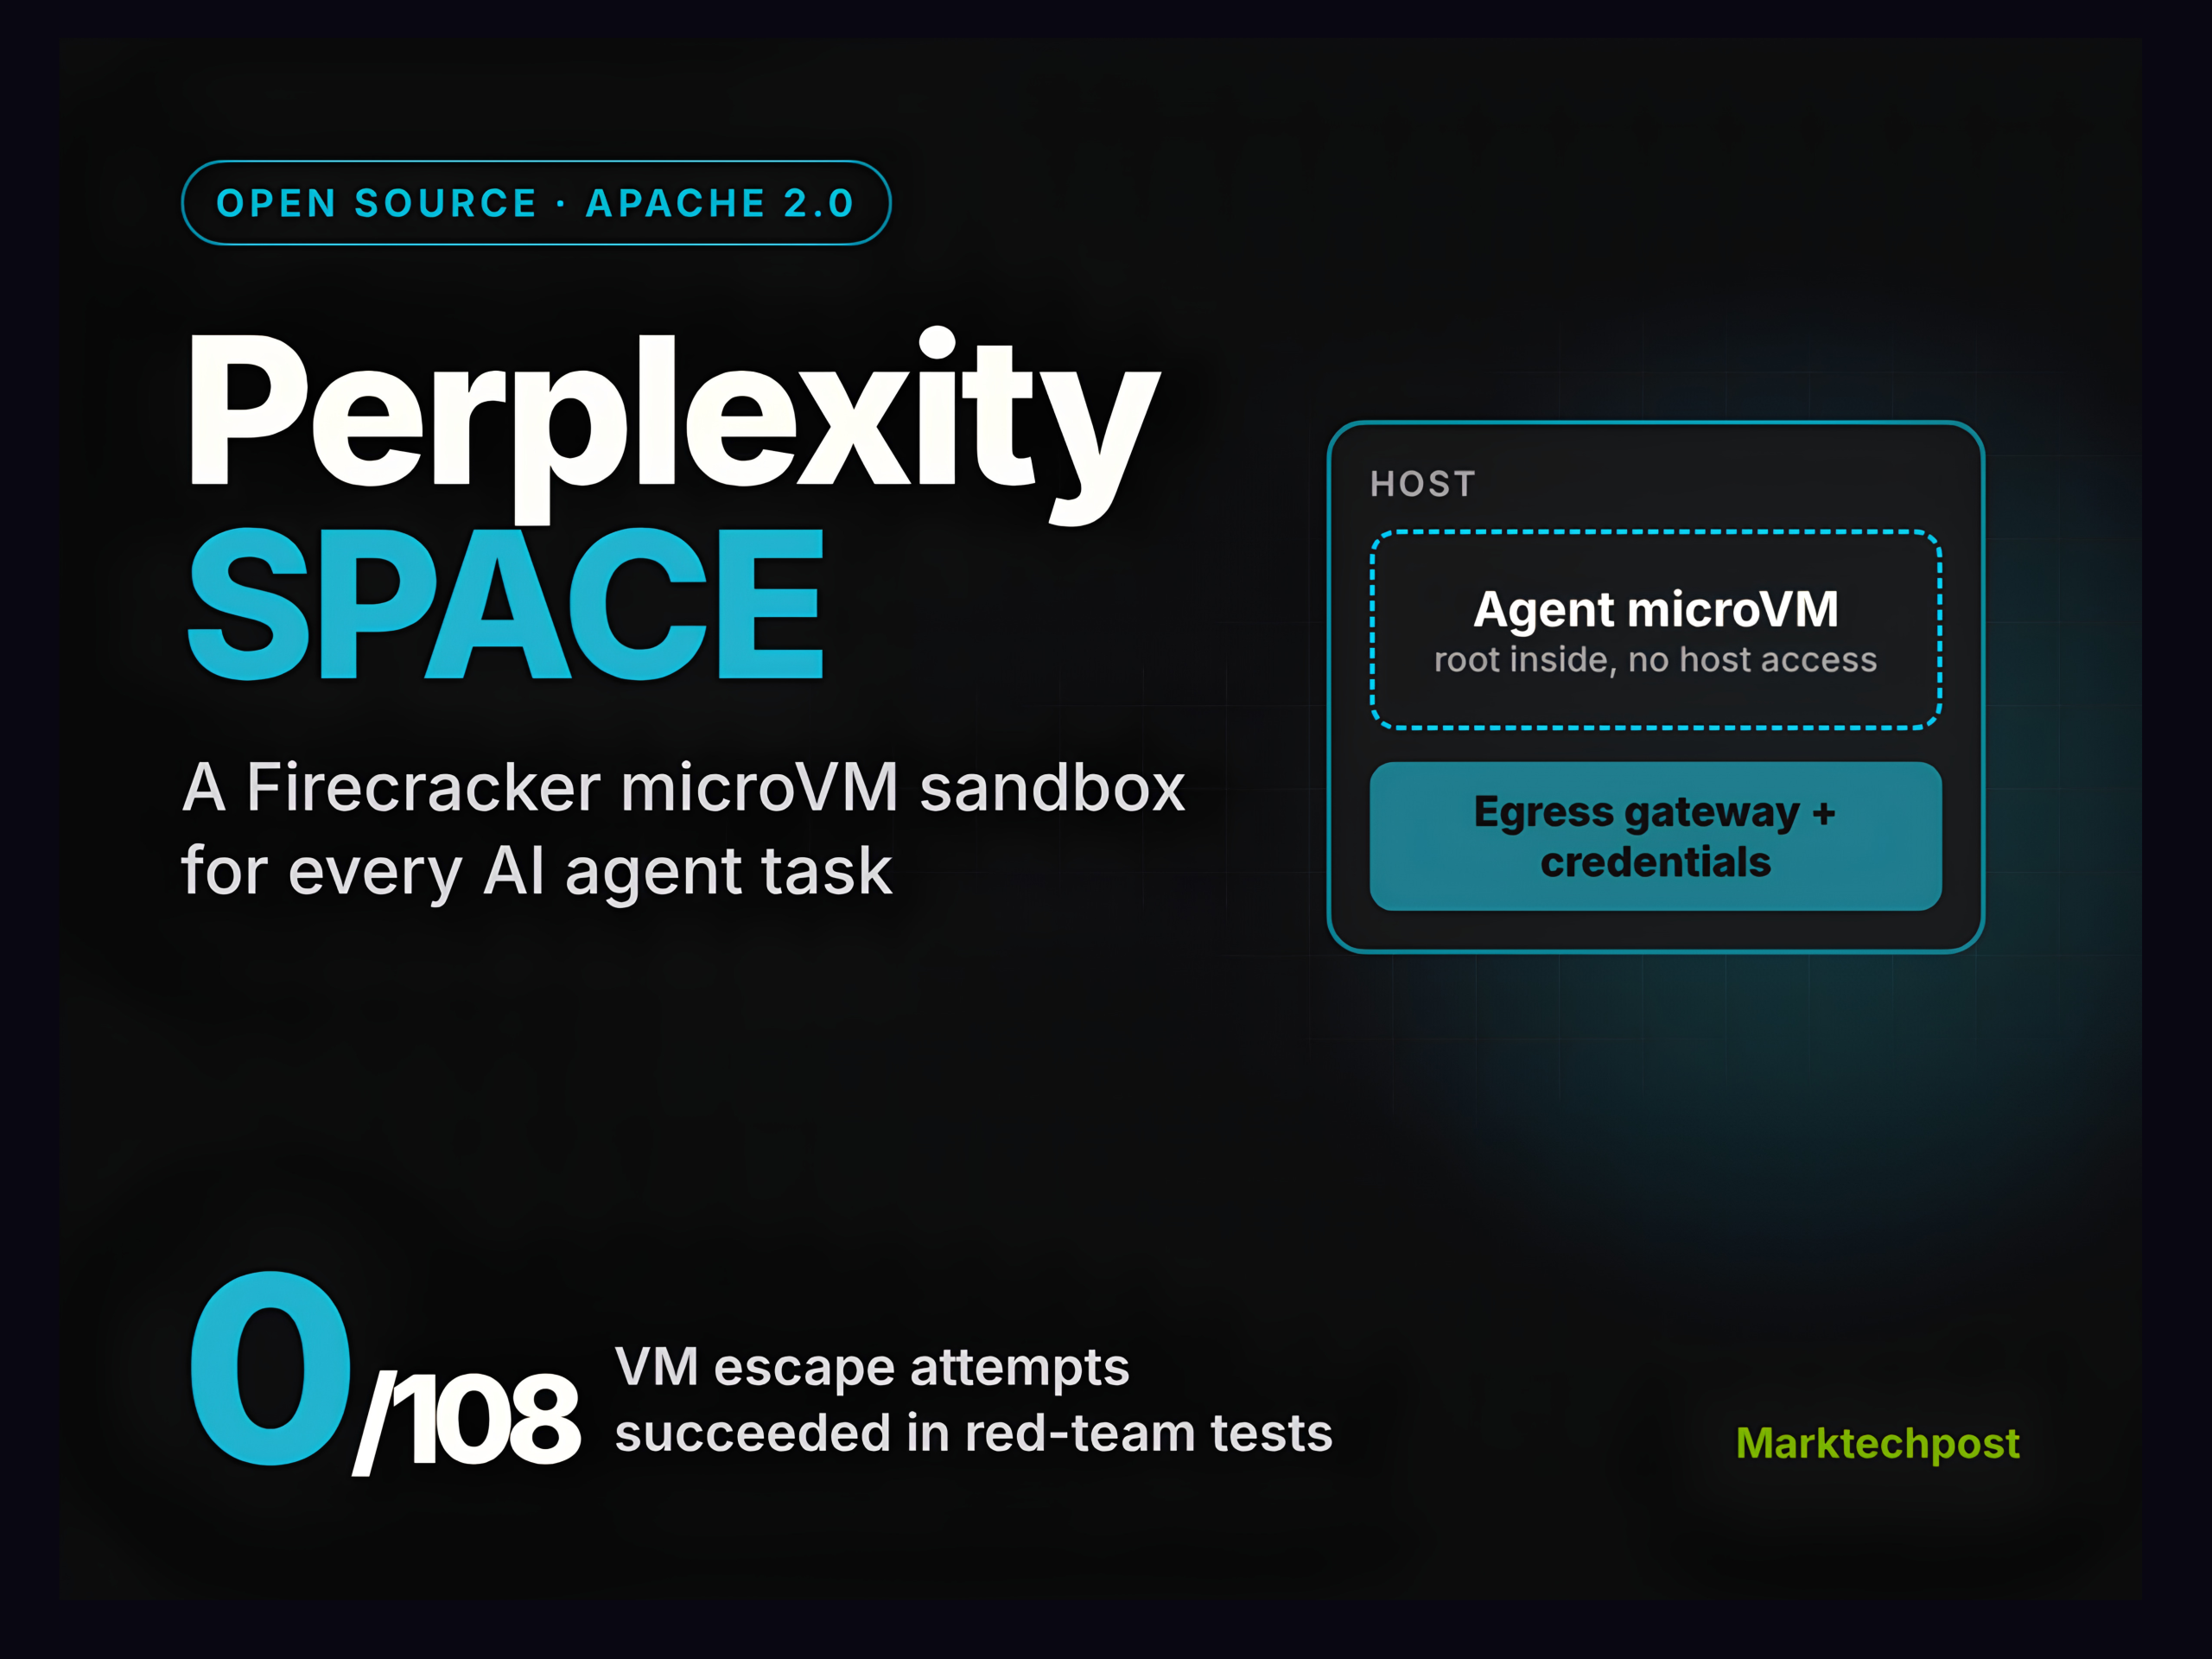
Perplexity ha lanzado SPACE, una plataforma de sandbox de código abierto diseñada para ejecutar tareas de agentes de IA de forma segura en microVMs aisladas. La plataforma, disponible bajo Apache 2.0 en GitHub, proporciona una capa de aislamiento probada en producción para los equipos que desarrollan agentes de codificación o de navegación. SPACE utiliza microVMs Firecracker, con cada sandbox teniendo su propio kernel de invitado y puerta de enlace de red para hacer cumplir las políticas de salida. Los secretos se mantienen fuera del invitado, con las credenciales inyectadas en la capa de red, lo que ofrece un alcance jerárquico, límites de velocidad y registro de auditoría. El sistema se divide en cuatro componentes: una API basada en PostgreSQL, controladores, servicios de trabajador y un plano de datos. Los servicios de trabajador gestionan las VM, la red, los volúmenes, las plantillas y las credenciales, con btrfs copy-on-write que crea los sistemas de archivos raíz. Los sandboxes pueden estar en cuatro estados: en ejecución, pausado, suspendido o eliminado. Las implementaciones de Kubernetes utilizan piscinas cálidas para una creación rápida, mientras que las configuraciones de un solo nodo utilizan instantáneas base. Perplexity informó que el 100% de las sesiones de ordenador se ejecutan en SPACE, con una latencia reducida de 89 ms desde 447 ms. Un informe de seguridad probó nueve modelos, encontrando vulnerabilidades en cuatro, incluidos Claude Opus 5.0 y GPT-5.6 Sol. Perplex, la empresa, añadió la validación de la dirección de origen a través de nftables, y las pruebas posteriores no mostraron vulnerabilidades verificadas. El equipo también probó diez plataformas de terceros, con ocho mostrando vulnerabilidades en las políticas de red, y divulgó los resultados a los proveedores afectados.
Itaú amplía la IA generativa para atender a toda Su base de clientes para finales de 2026
Itaú, el banco más grande de Brasil, está utilizando la IA generativa para mejorar las experiencias de los clientes y los empleados a través de su estrategia de IA First. La plataforma ia.i del banco, una interfaz conversacional, tiene como objetivo atender a toda su base de clientes para finales de 2026. Carlos Eduardo Mazzei, el director de tecnología de Itaú, destacó la importancia de la simplicidad y la directividad en las soluciones de IA, afirmando que la tecnología debería ser casi imperceptible para los clientes. Un estudio de Itaú y Grupo Consumoteca reveló que el 80% de los brasileños buscan una mejor organización financiera, con el 65% interesado en asistentes financieros. La estrategia de IA del banco incluye la plataforma de gobierno IARA, que gestiona el acceso a varios modelos, garantizando prácticas de IA responsables. IARA apoya soluciones como el análisis automatizado de documentos del departamento legal, que procesa más de 2 millones de tareas mensualmente, con ahorros de eficiencia del 20% al 80%. Mazzei destacó la necesidad de un uso seguro y controlado de los modelos para mantener la viabilidad económica. La plataforma también impulsa Customer DNA, enriqueciendo el contexto financiero de 70 millones de clientes utilizando modelos GPT. Itaú planea ampliar las capacidades de ia.i, incluyendo simulaciones de productos y análisis financieros recurrentes, para finales de año. El banco espera triplicar el tiempo de las relaciones con los clientes, duplicar la velocidad del servicio y triplicar la eficacia de las conversaciones. Mazzei enfatizó que la IA debe estar en línea con los valores del banco, reduciendo los sesgos y garantizando la relevancia cultural en las interacciones con los clientes.
Elorian lanza modelo de IA que interactúa directamente con datos visuales
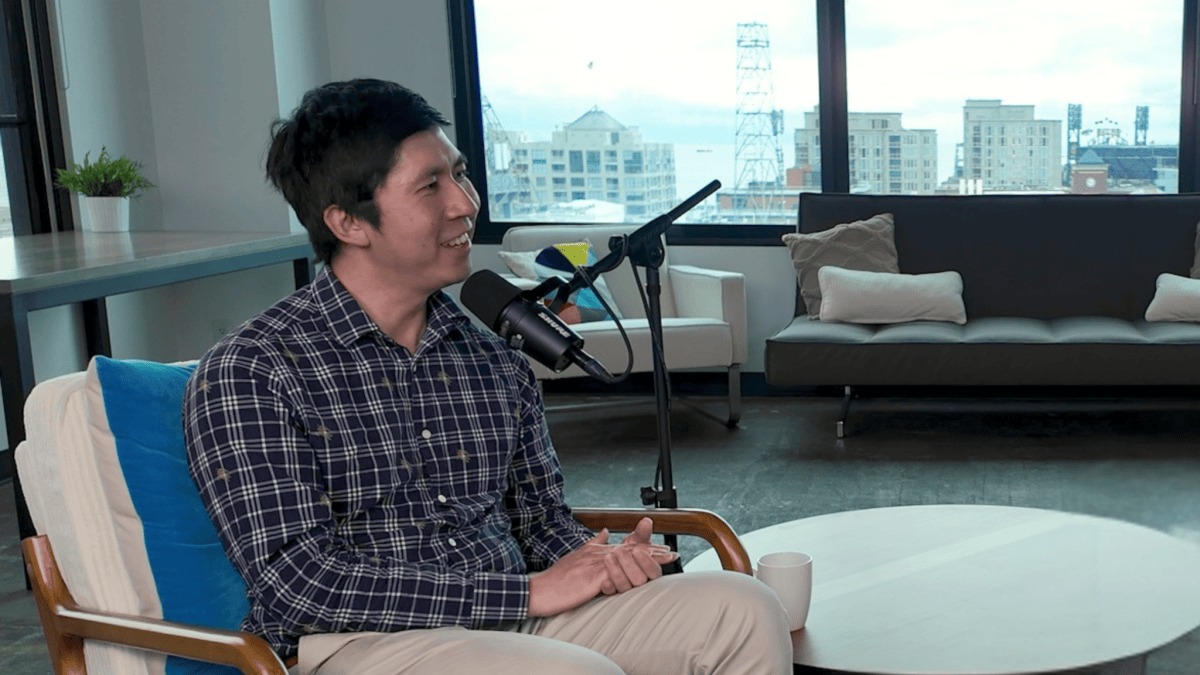
Elorian, una startup de IA con sede en Palo Alto, ha lanzado su primer modelo, Glimpse, que permite la interacción directa con datos visuales. El modelo, lanzado como una versión de preproducción, ofrece acceso a la API y una interfaz de chat, actualmente disponible solo a través de una lista de espera. Glimpse permite que la IA revise el material original durante el razonamiento, lo que le permite recortar imágenes, extraer fotogramas de vídeo o ejecutar código para el análisis, una función que la empresa denomina un 'espacio de trabajo visual'. Andrew Dai, CEO de Elorian, ex investigador de Google DeepMind, destacó las limitaciones de los modelos de IA actuales en la comprensión de las señales visuales, citando ejemplos como los juegos de mesa y los diagramas de IKEA. Señaló que, si bien los humanos pueden interpretar estas visualizaciones con un mínimo de texto, los modelos de IA tienen dificultades para comprender su significado. Sin embargo, Glimpse supera a modelos como GPT-6 Astra en el razonamiento de gráficos científicos y la creación de subtítulos para vídeos cortos. La startup, que surgió de forma discreta hace seis meses, ha conseguido una ronda de financiación inicial de 55 millones de dólares a una valoración de 300 millones de dólares. Glimpse cuesta 0,60 dólares por millón de tokens de entrada y 3 dólares por millón de tokens de salida, lo que lo sitúa entre los modelos de nivel medio y ligeros. El objetivo de Elorian es desarrollar el 'mejor modelo de razonamiento visual del mundo' para el próximo año, apuntando a industrias con grandes conjuntos de datos de vídeo, incluyendo la robótica y los medios.
El procesador Nvidia rtx spark n1x impulsa nuevas laptops, compitiendo con los principales fabricantes de chips
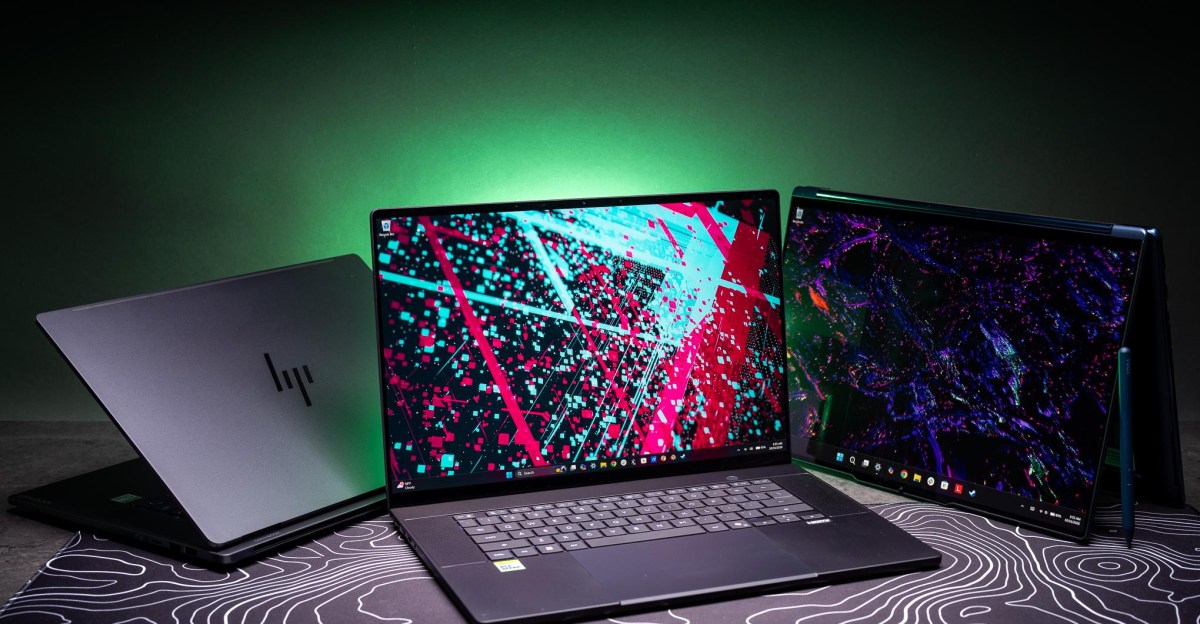
Nvidia ha lanzado su procesador RTX Spark N1X, un SoC basado en Arm de alto rendimiento, dirigido a laptops y escritorios pequeños, compitiendo con las ofertas de Apple, Intel, AMD y Qualcomm. El chip cuenta con numerosas unidades de procesamiento, gráficos Nvidia RTX Blackwell y suficiente potencia y memoria unificada para ejecutar modelos de IA locales grandes. El dispositivo insignia es el Microsoft Surface Laptop Ultra, equipado con 128 GB de memoria unificada, revisado por Tom Warren. Sean Hollister está probando una versión de 64 GB del modelo de Asus. The Verge proporciona más detalles sobre el rendimiento y las capacidades de estas nuevas laptops, destacando los avances de Nvidia en el mercado de procesadores para laptops. El RTX Spark N1X representa un importante paso en la expansión de Nvidia en los mercados de laptops y escritorios, aprovechando su experiencia en gráficos y IA. Con su combinación de gráficos potentes y memoria unificada, el procesador está posicionado para desafiar a los líderes existentes en la industria. Los modelos Surface Laptop Ultra y Asus son algunos de los primeros dispositivos que muestran el potencial de esta nueva tecnología, ofreciendo a los usuarios un rendimiento y capacidades mejorados para ejecutar modelos de IA complejos localmente. La cobertura de The Verge proporciona un análisis en profundidad del rendimiento y las características de estos dispositivos, destacando la creciente influencia de Nvidia en el espacio de la informática.
Los juguetes y dispositivos de IA están a punto de transformar la temporada navideña
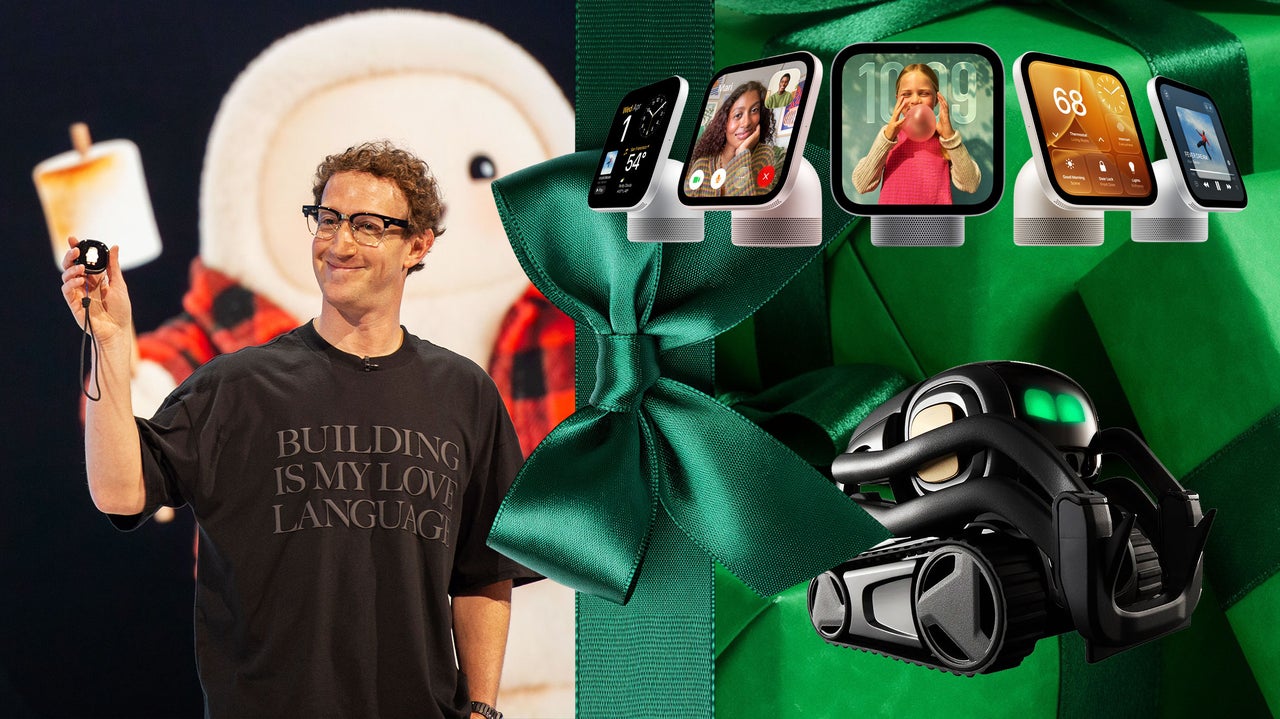
Se espera que la temporada navideña de 2026 cuente con una amplia gama de dispositivos de IA para niños y adultos, con importantes empresas tecnológicas presentando nuevos productos. Apple lanzó HomeView, un dispositivo doméstico inteligente impulsado por Siri, que utiliza la IA, lo que permite a los usuarios controlar los timbre, los termostatos y las cerraduras. Amazon presentó nuevas tabletas Alexa que funcionan con Alexa+, con precios que oscilan entre 229 y 500 dólares. Microsoft está a punto de lanzar la Surface Laptop Ultra, que está equipada con un chip de IA de Nvidia, con un precio de 2.599 dólares, y comenzará a enviar envíos el 16 de octubre. Meta está expandiendo sus ofertas de IA con Muse Charm, un llavero similar a Tamagotchi, y una nueva línea de gafas con IA, que incluyen modelos sin cámaras, para abordar las preocupaciones sobre la privacidad. La empresa planea ofrecer 100 modelos de gafas de IA para finales de año. Estos desarrollos destacan la creciente integración de la IA en la vida cotidiana durante la temporada navideña. Meta también presentó una versión de Windows de su agente de IA Muse, con el objetivo de aprovechar su popularidad en la App Store de Apple. La empresa tiene planes ambiciosos para su Muse Charm, que puede gestionar tareas como la organización de la bandeja de entrada y las reservas de cenas. Con los juguetes de IA ya en el mercado y un aumento en los dispositivos impulsados por la IA, la temporada navideña está a punto de ser un hito importante en la adopción de la tecnología de IA.
Tencent presenta un marco de memoria de código abierto para agentes de IA
Tencent ha lanzado Hy Memory 2.0, un marco de memoria de código abierto para agentes de IA, junto con un modelo dedicado y la aplicación MemHub. El marco admite la memoria para chat, trabajo y código, lo que permite a los desarrolladores integrarlo en sus agentes. Hy Memory 2.0 ha superado a varios marcos existentes en las pruebas de referencia, obteniendo las puntuaciones más altas en las áreas de memoria y las pruebas de código. Tencent afirma que es el primero en introducir la memoria para el trabajo y el código en un marco de memoria. El modelo Hy-Memory-30A3B, entrenado en varios marcos, ha superado a Claude Opus 5 en rendimiento. MemHub, una herramienta de gestión de memoria local, permite a los usuarios sincronizar las conversaciones entre las herramientas de IA. El SDK y los pesos del modelo ahora están disponibles en GitHub y Hugging Face, respectivamente. Tencent tiene previsto refinar aún más las capacidades de memoria en aplicaciones del mundo real.
Liquid AI supera al modelo jev 1.14 de typesafe AI con el modelo d1-ultra
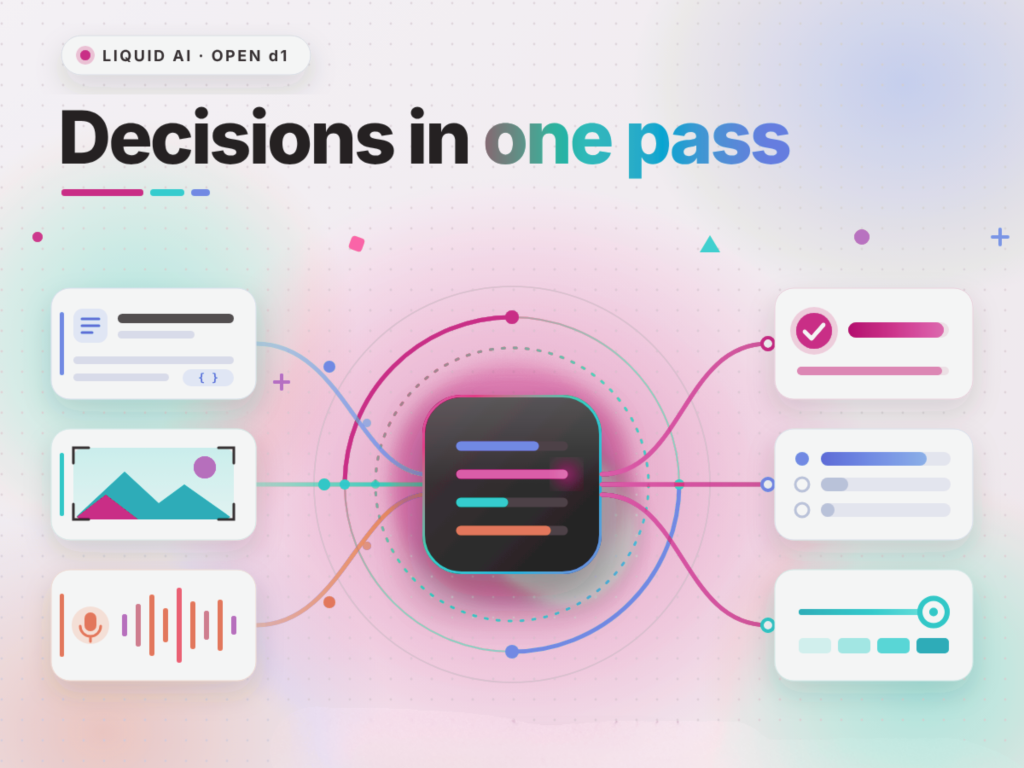
TypeSafe AI presentó su modelo de decisión JEV 1.14 el 14 de octubre de 2026, en horario del Pacífico, introduciendo funciones como la entrada de imágenes y un nuevo tipo 'caja'. El modelo admite un contexto extendido, hasta 262.000 tokens. Solo un día después, Liquid AI anunció su modelo d1-ultra, afirmando que supera al JEV 1.14 en ocho tareas. El d1-ultra también supera al router semántico vLLM d3 en el rendimiento general. El modelo de Liquid AI se posiciona como el 'mejor del mundo', estableciendo un nuevo estándar en las capacidades de toma de decisiones. La rápida respuesta de Liquid AI destaca el ritmo competitivo en el desarrollo de la IA, con importantes avances en el rendimiento y la funcionalidad del modelo.