Micron desenvolve memória de inferência de borda para aplicações de IA física
A Micron está avançando no desenvolvimento de um chip de armazenamento especializado para aplicações de IA física, chamado Memória de Inferência de Borda (EIM). Em um fórum de semicondutores em Seul durante o SEDEX 2026, o executivo da Micron, Lee Jeok, enfatizou o rápido crescimento de mercados como a condução autônoma, robôs humanoides e AR/VR, e mencionou a colaboração da empresa com clientes-chave para desenvolver produtos adaptados para essas áreas. A EIM é projetada para processar dados de inferência de IA rapidamente, empilhando memória de baixo consumo de energia sobre chips de lógica, diferenciando-se da computação em memória (PIM) em arquitetura, mas compartilhando o objetivo de melhorar a eficiência de dados. A Micron ainda não divulgou métricas de desempenho para a EIM, mas está trabalhando para integrá-la com LPDDR6. Especialistas do setor preveem a produção em massa até o final de 2028. Robôs humanoides, que exigem sensoriamento e tomada de decisões em tempo real do ambiente, exigem maior largura de banda de memória do que robôs industriais tradicionais. Atualmente, eles dependem da memória LPDDR, mas, à medida que os modelos de IA se tornam mais complexos, a Micron prevê uma mudança para memória de alta largura de banda (HBM). Lee Jeok observou que, embora os modelos atuais usem de 1B a 2B parâmetros, os futuros modelos de linguagem visual exigirão HBM. A Micron também antecipa a necessidade de 200 GB de DRAM e 4 TB de armazenamento em robôs humanoides avançados, em comparação com 12 GB de DRAM e 256 GB de armazenamento nos modelos atuais. A empresa está colaborando com fabricantes de robôs, projetistas de chips e provedores de nuvem para moldar os primeiros designs de sistemas para IA física.
OpenAI avança em robôs humanoides com foco na 'mente' de IA
A OpenAI, liderada pelo CEO Sam Altman, está avançando com seu projeto de robôs humanoides, enfatizando o desenvolvimento de uma 'mente' de IA em vez do design físico. Altman afirmou que a forma humanóide é lógica, pois o mundo é projetado para humanos, com ferramentas e ambientes moldados para a anatomia humana. Ele observou que a prioridade é criar uma 'mente' que permita que o robô use seus membros de forma eficaz, em vez de se concentrar na estética. A OpenAI planeja apresentar um protótipo em 2027, mas espera que a implantação completa leve vários anos. O projeto envolve tarefas complexas como manipulação de objetos e adaptação ao ambiente, exigindo aprendizado de máquina e experiência em robótica avançados. A OpenAI está contratando em várias áreas, incluindo controle de movimento e desenvolvimento de hardware, e já fez progressos com projetos como Dactyl, que treinou mãos robóticas em ambientes simulados. Embora empresas como Tesla e Xiaopeng tenham desenvolvido robôs humanoides, o foco da OpenAI permanece na integração de IA e aplicações práticas, como suporte à infraestrutura e assistência pessoal, sem que um preço ou data de lançamento tenham sido anunciados.
Lenovo apresenta o p7, um host com IA, com combinação de chips personalizada
A Lenovo anunciou em 18 de outubro que lançará o AI Host P7 em 24 de outubro, durante um evento especial em Changsha, China. O dispositivo estará disponível para pré-venda no mesmo dia. O P7 é alimentado por uma combinação de chips personalizada da Zhixin Technology e Houmo Intelligence, com o SoC P1 e o dNPU M50. Esta configuração fornece 190TOPS de poder de computação de IA local, permitindo o lançamento de modelos LLM de 122B com uma janela de contexto de 128K e uma taxa de inferência local de 50TPS. O lançamento segue um anúncio feito em maio, onde a Lenovo detalhou as especificações técnicas do P7. O AI Host P7 é posicionado como um dispositivo de alto desempenho para desenvolvedores e entusiastas de IA, aproveitando os mais recentes avanços na tecnologia de chips de IA.
Kyutai apresenta o REKI: um modelo vla de 2,4B parâmetros para melhorar a manipulação robótica com memória eficiente
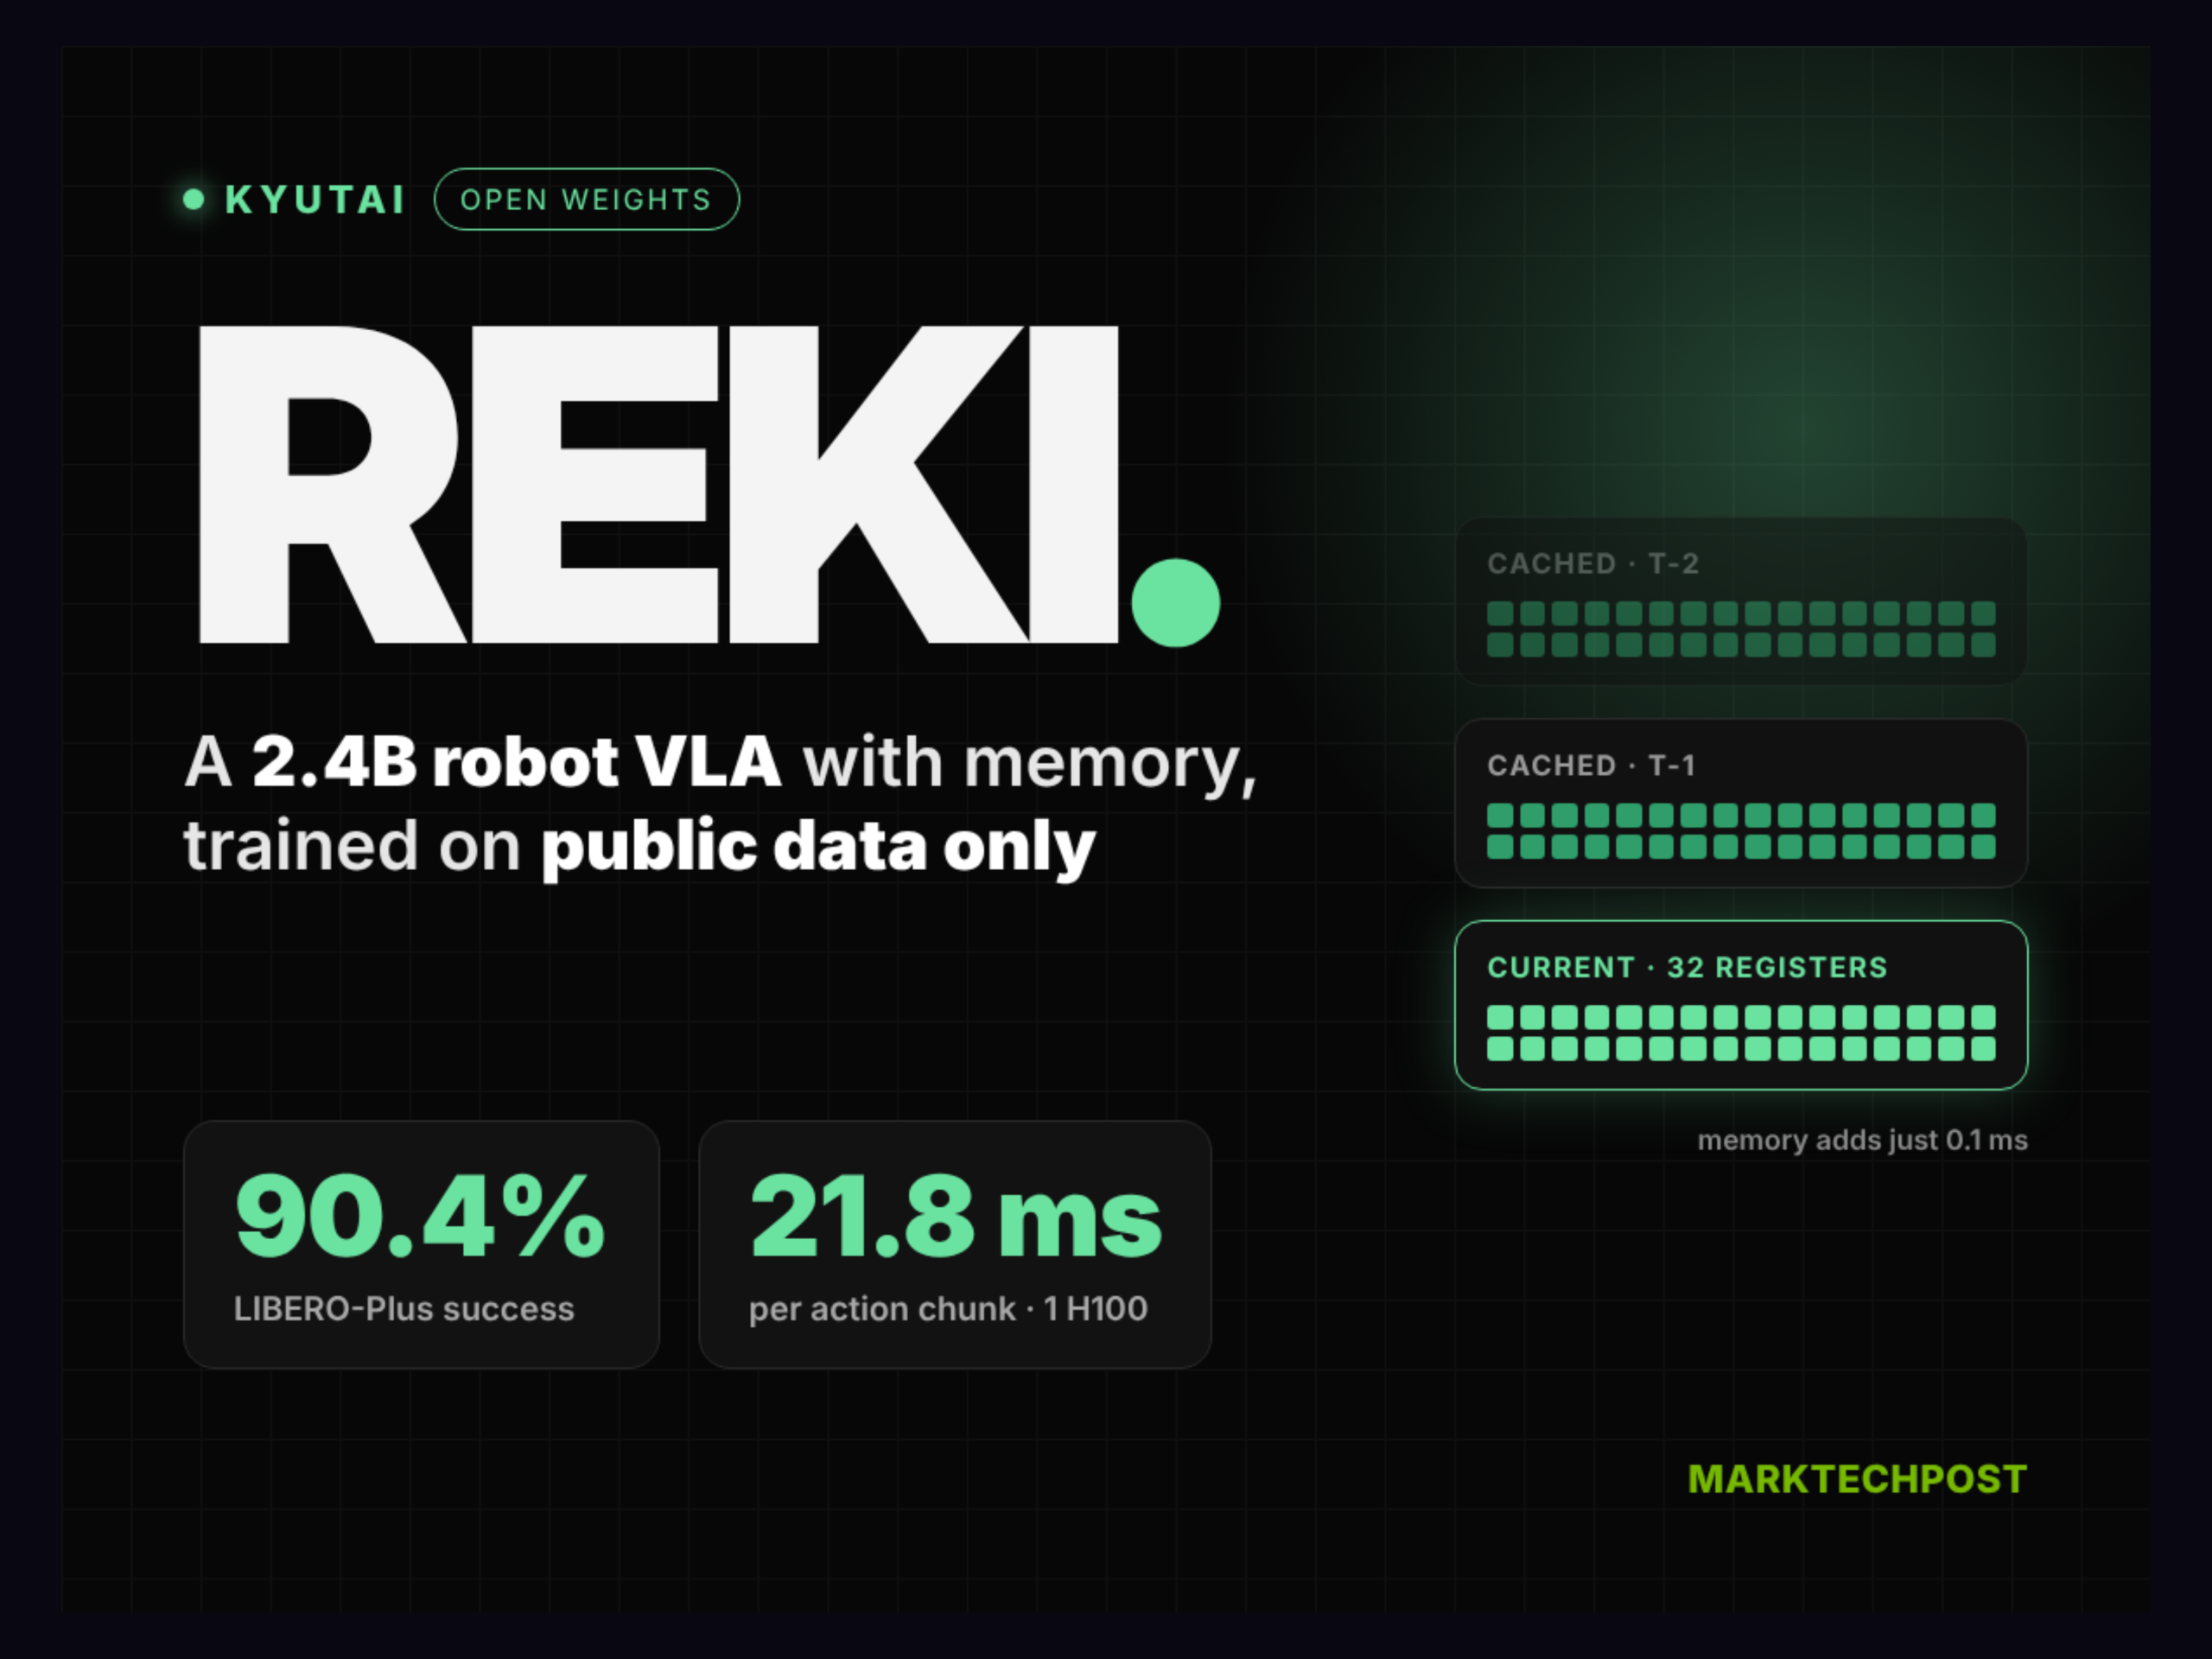
A Kyutai, em colaboração com a Inria e a École des Ponts, apresentou o REKI, um modelo visão-linguagem-ação (VLA) de 2,4B parâmetros, projetado para melhorar a manipulação robótica. O REKI foi pré-treinado em dados públicos e possui um sistema de memória de baixo custo que retém informações recentes. Ele supera modelos de tamanho semelhante em três benchmarks fora da distribuição, com apenas modelos maiores o superando. Todos os pesos do modelo estão agora disponíveis no Hugging Face. O REKI integra uma estrutura Qwen3.5-2B com um especialista de ação de 200M parâmetros, gerando fragmentos de ação através de correspondência de fluxo em 10 passos de Euler. O modelo utiliza RMSNorm adaptativo para o estado e o tempo do fluxo, com cada layout de estado tendo sua própria pequena MLP de estado. Ao contrário da maioria dos VLAs que dependem apenas do quadro atual, o REKI incorpora a memória no especialista de ação, utilizando 32 tokens de registro aprendidos que atendem cruzadamente prompts e visualizações codificadas, enquanto atendem de forma autônoma aos quadros anteriores. Este design reduz a oscilação nos braços robóticos, reduzindo as taxas de falha no RoboTwin de 18,6% para 4,1%. O pré-treinamento aumenta significativamente o desempenho, adicionando 13,8 pontos em Clean2Rand e 30,3 em clutter. A memória melhora ainda mais os resultados, adicionando 1,5 pontos em LIBERO-Plus e 5,4 em RoboCasa365. O modelo é pré-treinado uma vez e ajustado para cada benchmark, com seis checkpoints disponíveis, incluindo versões para LIBERO, RoboTwin, RoboCasa365 e RoboCasa-GR1. O REKI é otimizado para implantação em robôs reais usando o protocolo LeRobot, com ajuste fino em um braço UR5 exigindo 3.000 passos em uma hora.
Anthropic remove o haiku 4.5 dos modelos públicos
A Anthropic anunciou, em 15 de outubro de 2026, que o Haiku 4.5 será removido dos planos Free, Pro e Max, a partir de 29 de outubro de 2026. A alteração afeta todas as plataformas, incluindo a web, desktop e móvel, bem como funcionalidades como Claude Cowork e Claude Design. Os utilizadores ainda podem aceder ao Haiku 4.5 através da secção 'Mais modelos' até 29 de outubro, após a qual não aparecerá mais no seletor de modelos. Se os utilizadores estão atualmente a usar o Haiku 4.5, o sistema irá automaticamente mudar para o Haiku 5.5. A atualização não afeta a disponibilidade do Haiku 4.5 nos planos Claude Code, Team, Enterprise ou através da API da Anthropic. As conversas existentes com o Haiku 4.5 permanecerão intactas, e os utilizadores poderão continuar a interagir com elas usando o Haiku 5.5 após 29 de outubro. Também poderão exportar os seus dados de chat, se necessário. Haiku 5.5, lançado em 7 de outubro de 2026, é o primeiro modelo da série a permitir níveis de pensamento ajustáveis, com uma janela de contexto de 1 milhão de tokens e uma saída máxima de 128K tokens. Apresenta melhorias significativas nas tarefas de codificação e de agente em comparação com o Haiku 4.5. A Anthropic observou que o custo médio de execução do Haiku 5.5 é cerca de 75% inferior ao do Haiku 4.5, com uma redução de custo de 90% para prompts com menos de 100.000 tokens, o que cobre aproximadamente 90% de todas as solicitações na série.
China lança o primeiro sistema de previsão do tempo totalmente autônomo
A China implantou seu primeiro sistema totalmente autônomo de previsão do tempo, 'Fengqing', que já está em operação em todo o país. Desenvolvido pelo Centro Nacional de Meteorologia em colaboração com várias universidades e institutos de pesquisa, o sistema utiliza o Centro de Supercomputação Nacional em Tianjin, no cluster de supercomputação AI4S. É o primeiro sistema na China a alcançar controle total sobre dados, modelos e poder de computação, representando um avanço significativo na tecnologia de IA meteorológica. O Fengqing utiliza uma arquitetura Transformer visual combinada com restrições de física meteorológica para melhorar a precisão das previsões para eventos climáticos extremos, como tufões e chuvas fortes. O sistema pode prever as condições climáticas com até 11 dias de antecedência, superando os sistemas de previsão baseados em IA mais recentes do Centro Europeu de Previsão do Tempo de Médio Prazo (ECMWF) em várias métricas-chave. Também permite simulações globais rápidas do tempo, aprimorando a capacidade de prever tendências climáticas de longo prazo e eventos extremos. O sistema apoiará vários setores, incluindo prevenção de desastres, transporte, gestão de energia e serviços públicos. O investimento contínuo de Tianjin em supercomputação e IA permitiu esta inovação, que se espera fortalecer as capacidades da China em inovação meteorológica e previsão global do tempo.
DeepSeek lança a versão V4.1-Flash-1017 com melhor desempenho e custos reduzidos
Em 17 de outubro de 2026, a DeepSeek anunciou o lançamento da versão V4.1-Flash-1017, atualizando seu site oficial, aplicativo e modelos de API. A nova versão alcança uma melhoria de Pareto em desempenho e eficiência de custo, com capacidades de modelo aprimoradas e tempos de execução de tarefas e comprimento de saída reduzidos, levando a custos gerais mais baixos por chamada. A DeepSeek destacou que o novo modelo permite que os usuários concluam tarefas de forma mais eficiente e a um custo mais baixo, alcançando novos pontos Pareto ótimos em desempenho e custo em várias plataformas. A atualização também inclui otimizações para DeepSeek Harness, Tencent CodeBuddy e WorkBuddy, com recomendações para que os usuários atualizem para a versão 0.2.1-rc.1 ou superior para aproveitar totalmente as melhorias. Além disso, a versão V4.1-Flash-1017 introduz capacidades aprimoradas de construção de projetos zero-shot por meio de aprendizado por reforço com feedback, suportando cenários como desenvolvimento de jogos e modelagem 3D. A DeepSeek afirma que isso permite que o modelo atenda a solicitações de programação 'baseadas em desejos', gerando projetos executáveis com entrada mínima. Os pesos do modelo estão agora disponíveis para download no HuggingFace e ModelScope, continuando a estratégia de código aberto MIT.
China lança a primeira plataforma de interconexão de agentes baseada em rede determinística
Em 16 de outubro de 2026, a décima Conferência de Desenvolvimento de Redes Futuras em Nanjing marcou o lançamento oficial do AXP, a primeira plataforma da indústria baseada em redes determinísticas para a interconexão de agentes. Desenvolvida pelo Laboratório de Purple Mountain em colaboração com China Mobile, Jiangsu Future Network Group e Jiangsu Future Network Innovation Research Institute, o AXP suporta até um milhão de registros de agentes e 100.000 agentes em execução simultaneamente. A plataforma permite a integração perfeita de redes de computação inteligente, conversão de protocolos e detecção rápida de falhas com tempos de resposta de subsegundos. O AXP, aproveitando o National Future Network Test Facility (CENI), permite o acesso preciso de agentes em diferentes domínios por mais de 4.000 quilômetros, reduzindo o tempo de execução de tarefas de ponta a ponta em mais de 20%. A plataforma está atualmente em fase de testes em vários cenários com operadoras de telecomunicações, fornecedores de equipamentos e grandes fabricantes de aço. Esta conquista representa um importante avanço tecnológico na infraestrutura da internet de agentes inteligentes da China, oferecendo um suporte de rede robusto para a colaboração de IA em diferentes domínios e implantação em larga escala.
Microsoft e carnegie mellon lançam o PRAISE para orientar programadores juniores na era da IA
A Microsoft e a Universidade Carnegie Mellon lançaram a iniciativa PRAISE, um programa de mentoria projetado para orientar programadores juniores em uma era em que a IA pode gerar rapidamente código e participar no design de sistemas. O projeto, inspirado no aconselhamento clínico na área da saúde, emparelha engenheiros em início de carreira com mentores experientes para promover o pensamento sistêmico, o julgamento e a responsabilidade. A iniciativa enfatiza que a IA muda a natureza do trabalho, e não a responsabilidade pela qualidade e segurança do software. A Microsoft argumenta que os engenheiros ainda devem entender a lógica subjacente do código para diagnosticar e corrigir falhas no sistema. A Carnegie Mellon fornecerá cursos formais e discussões em grupo para conectar a teoria da ciência da computação com o desenvolvimento de software no mundo real. Michael Hilton, professor da universidade, observou que o modelo tradicional de desenvolvimento de habilidades por meio de tarefas repetitivas não é mais suficiente, e uma nova abordagem é necessária para preparar os engenheiros juniores para o futuro impulsionado pela IA. A programação PRAISE visa garantir que os programadores juniores desenvolvam habilidades críticas, como julgamento e responsabilidade de engenharia, em vez de simplesmente imitar o comportamento da IA. Busca equilibrar a integração de ferramentas de IA com a necessidade de supervisão e expertise humanas. Ao combinar rigor acadêmico com prática industrial, a iniciativa espera criar um caminho sustentável para a próxima geração de engenheiros de software em um campo cada vez mais automatizado.
JetBrains lança junie local com suporte para nvidia rtx spark, atingindo 55 tokens por segundo
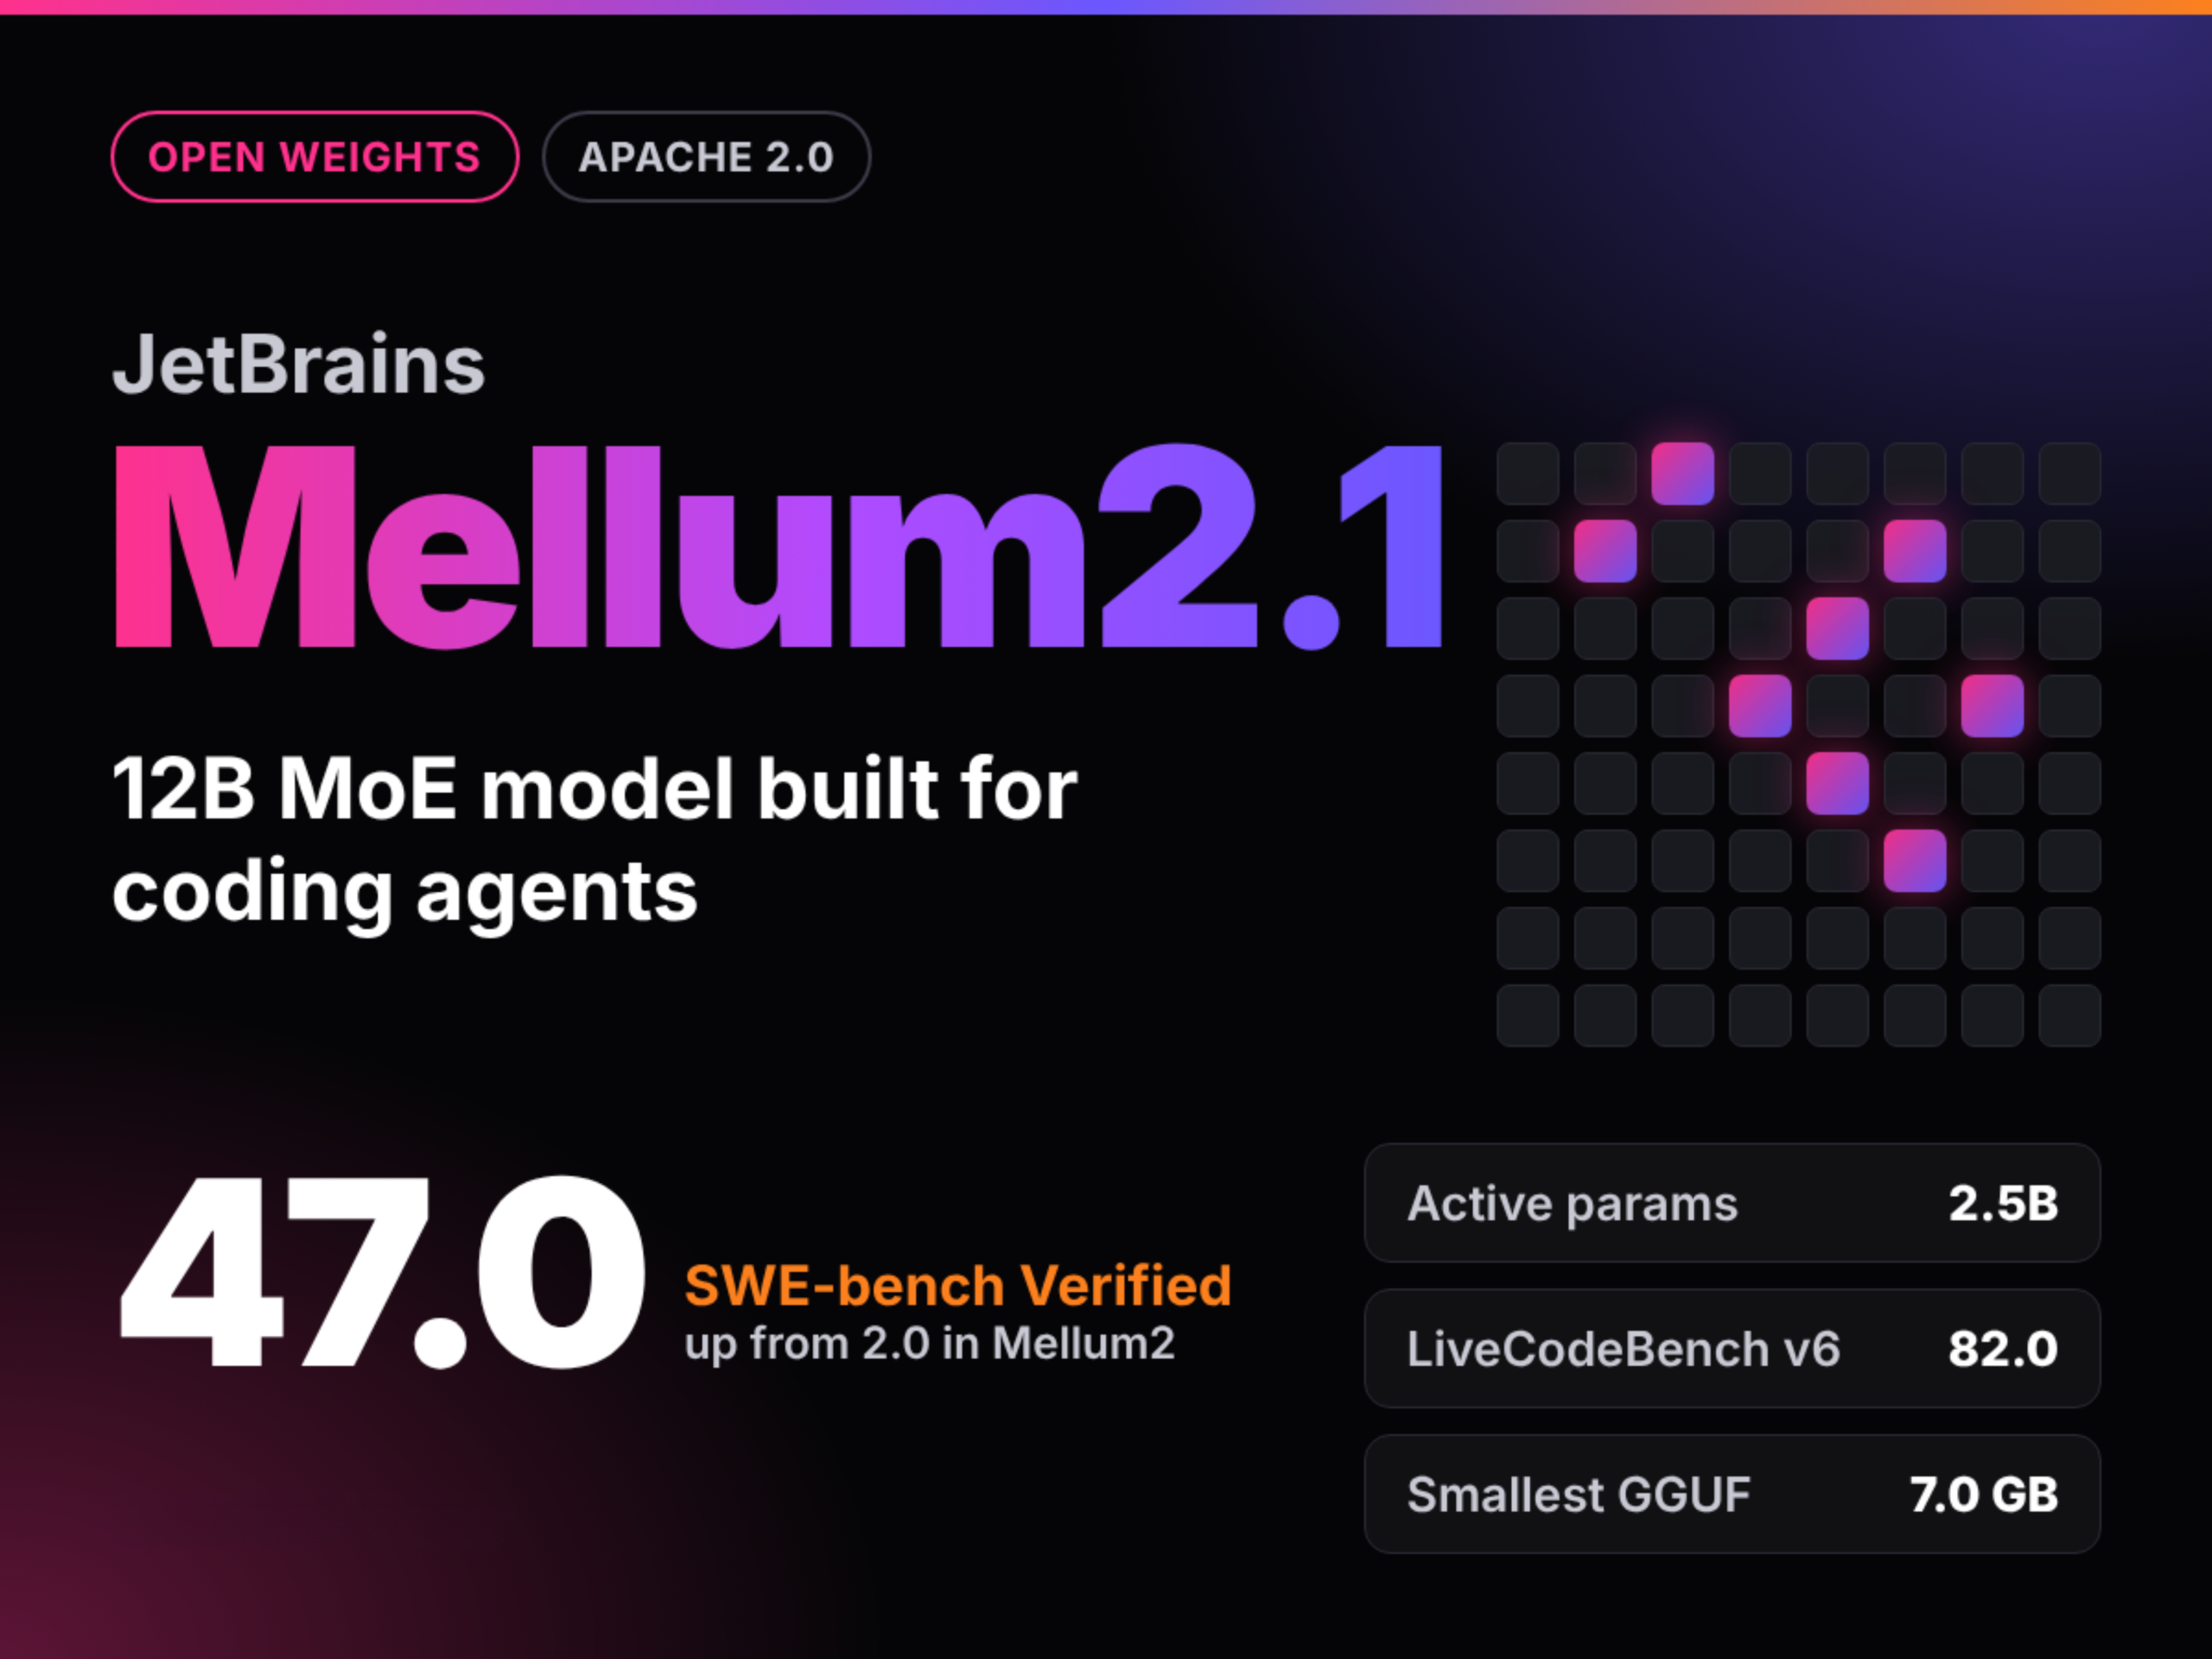
A JetBrains anunciou que sua ferramenta local de programação de IA, Junie Local, agora é compatível com a plataforma NVIDIA RTX Spark, na versão 0. A atualização também marca a transição do suporte para Windows de experimental para estável. Os usuários agora podem executar a ferramenta em hardware compatível, permitindo que a IA leia, modifique e execute código sem a necessidade de enviar dados para a nuvem. A ferramenta é gratuita para uso, sem necessidade de registro, assinatura ou custos de token. Em testes de desempenho, o Junie Local atingiu um throughput máximo de 55 tokens por segundo na plataforma RTX Spark. Os requisitos de hardware foram expandidos para incluir GPUs RTX 3090, 4090 e 5090 com pelo menos 24 GB de VRAM, juntamente com o Windows 11 e drivers NVIDIA atualizados. A nova versão do Junie Local verifica automaticamente GPUs e drivers compatíveis, implanta modelos e ajusta a capacidade do contexto com base na memória da GPU disponível. Os usuários podem escolher entre Qwen3.6-27B ou um modelo fornecido pela JetBrains. A ferramenta é projetada para reter mais histórico de código e conversas, aprimorando a capacidade da IA de auxiliar em tarefas de programação complexas.
Hagglebot de elon Musk visa aumentar a eficiência de custos corporativos em mais de 5%
Elon Musk, a pessoa mais rica do mundo, anunciou em 17 de outubro de 2026, através do X, que sua equipe está desenvolvendo uma ferramenta especializada de IA para negociação, chamada Hagglebot, para uso empresarial. O software de IA, projetado para ajudar as empresas a obter melhores acordos, é posicionado como um 'negociador de compras digital' que pode auxiliar nas negociações de preços com base em orçamentos e termos aceitáveis definidos pelo usuário. Musk estima que a ferramenta pode aumentar a eficiência de custos corporativos em 5% ou mais, potencialmente economizando até US$ 6 trilhões anualmente em escala global, se aplicada a toda a escala do PIB. A declaração seguiu uma postagem de um usuário destacando que o Hagglebot já havia economizado mais de US$ 100.000 para uma equipe em sua primeira semana de operação. Embora a ferramenta esteja focada na negociação comercial, e não em funções de chat gerais, os detalhes sobre suas estratégias de negociação, transações suportadas, cronograma de lançamento, preços e disponibilidade permanecem não divulgados.
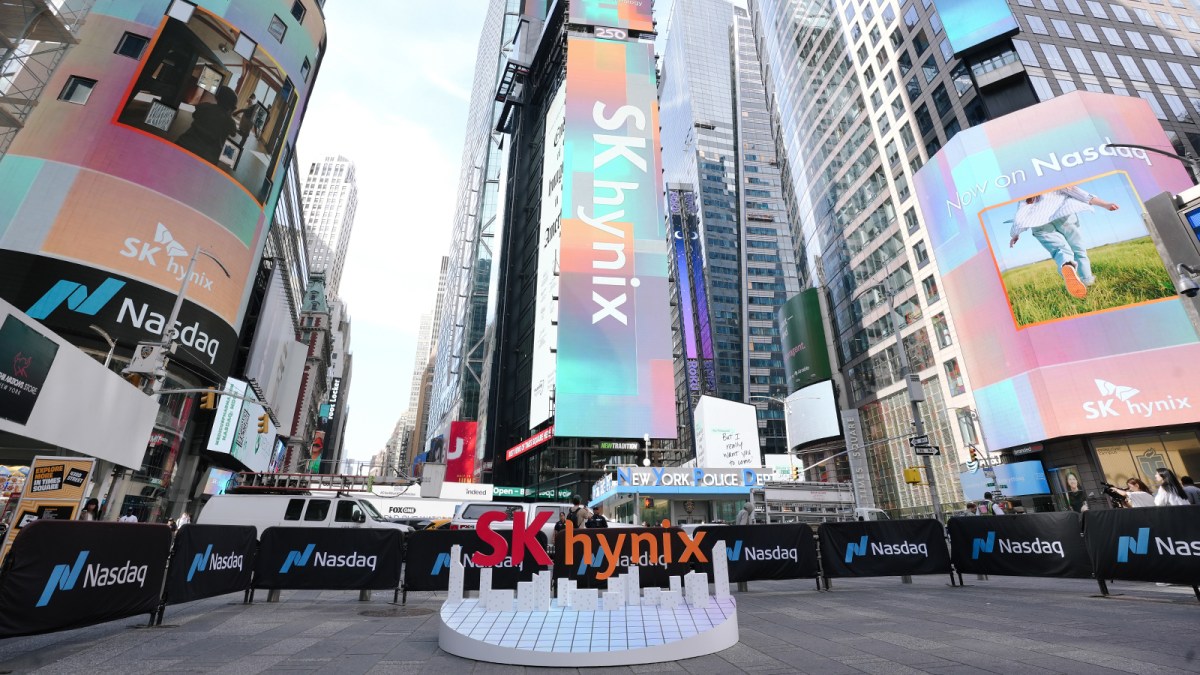
Intel anuncia planos para o processador 'razor lake ax' para IA física em 2028
O vice-presidente sênior da Intel, Jo Min-sung, anunciou na conferência 'Semiconductor-Driven Humanoid Robots' na Coreia do Sul que a empresa planeja lançar o processador 'Nova Lake' para o setor de IA física no início de 2027. Em seguida, a Intel pretende lançar o 'Razor Lake AX' em 2028, que oferecerá uma plataforma com um poder de computação total de 700 TOPS, significativamente superior aos 180 TOPS do 'Panther Lake'. O 'Razor Lake AX' será o primeiro SoC de GPU de grande memória e alto desempenho da Intel a ser comercializado. Ele utilizará a arquitetura de núcleo padrão 'Nova Lake' enquanto integra 16 ou 32 núcleos Xe3P, aprimorando tanto as capacidades de exibição gráfica quanto de inferência de IA. Isso representa um avanço significativo na estratégia da Intel para aplicações de IA física.
OpenAI aborda limitações de capacidade do modelo com melhorias do sistema e maior poder de computação
Em 16 de outubro de 2026, a IT Home reportou que o líder do Codex/ChatGPT da OpenAI, @thsottiaux, anunciou no X que a equipe havia implantado uma série de atualizações e adicionado mais poder de computação para resolver o erro de 'limite de capacidade do modelo'. As alterações faziam parte do plano de entrega contínua de 28 dias da OpenAI, com o 11º anúncio de atualização destacando as melhorias e os recursos adicionais destinados a reduzir a frequência do erro. Os usuários relataram que o problema nem sempre é devido ao modelo estar totalmente utilizado. Alguns usuários com limites de assinatura e switches de modelo suficientes ainda encontraram o erro repetidamente, enquanto os desenvolvedores suspeitam que possa estar relacionado a solicitações de backend, estados de sessão ou agendamento de recursos. A equipe da OpenAI otimizou o sistema e aumentou o poder de computação para reduzir a ocorrência do erro. Se o erro persistir, as tarefas devem agora continuar automaticamente em vez de ficarem em um estado de erro. A equipe também convidou os usuários que ainda estão enfrentando o problema a fornecer feedback para investigação adicional.
Perplexity lança sandbox de código aberto para segurança de agentes de IA
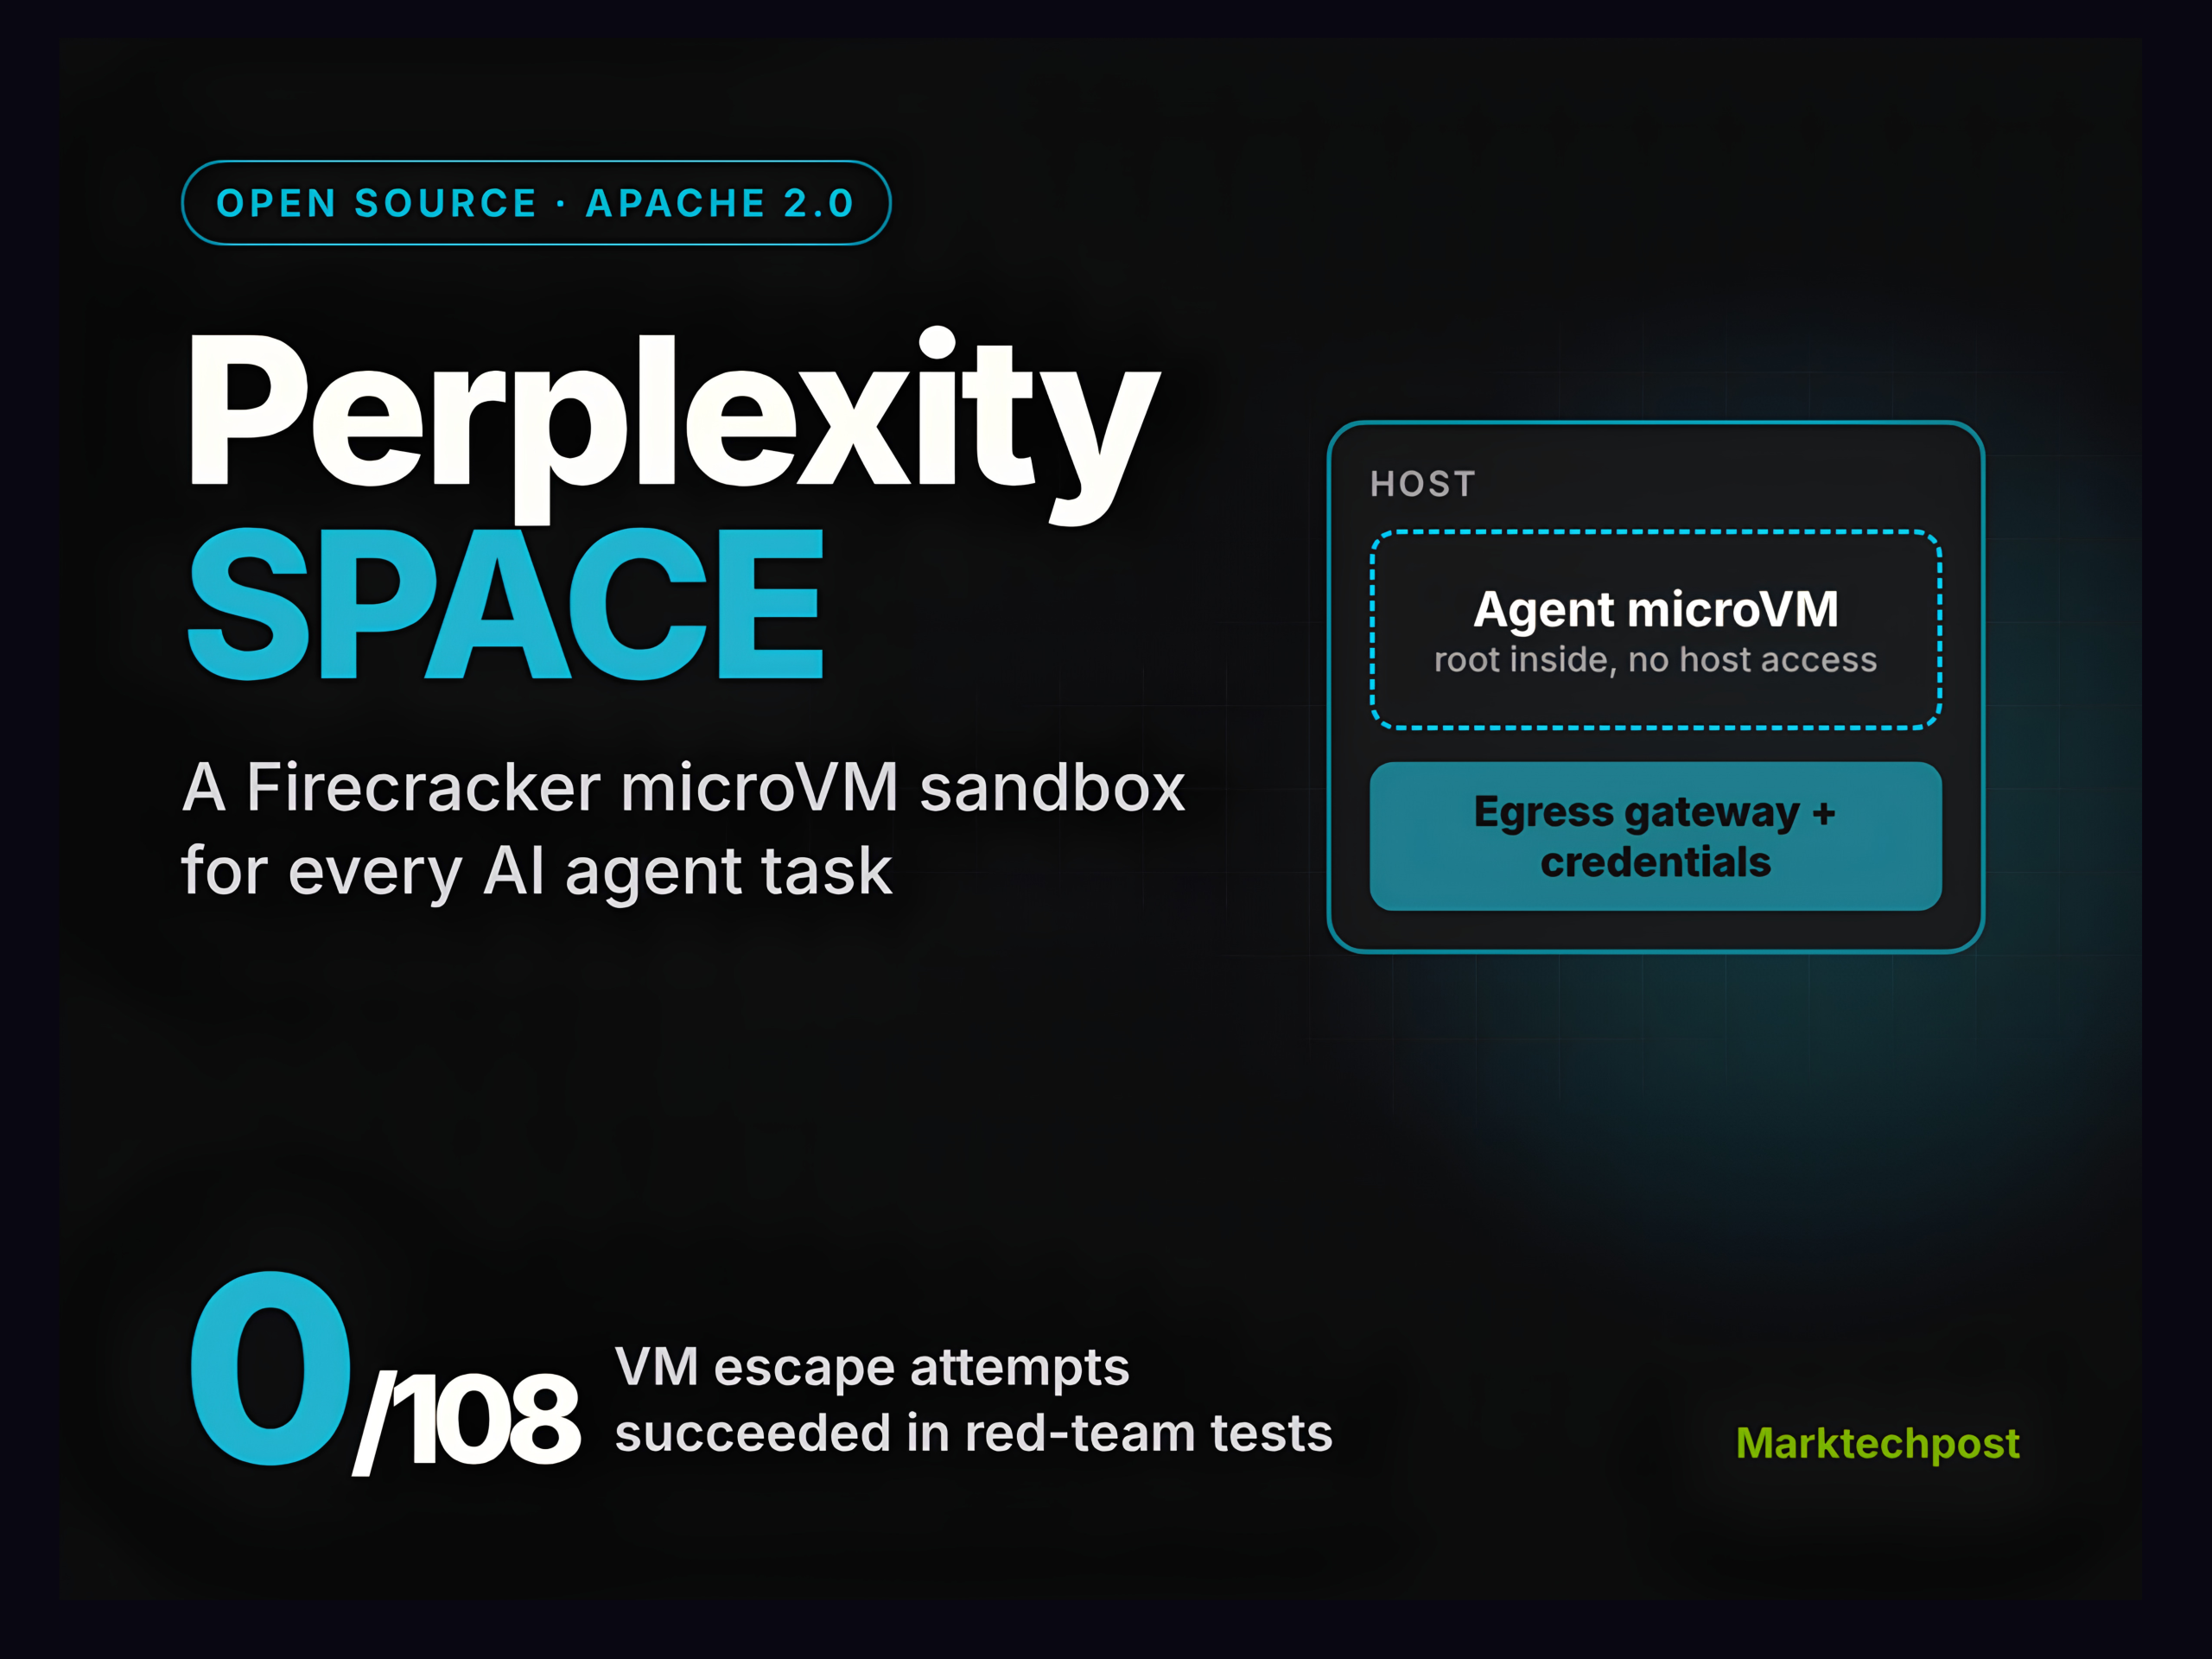
A Perplexity lançou o SPACE, uma plataforma de sandbox de código aberto, projetada para executar tarefas de agentes de IA de forma segura em microVMs isoladas. A plataforma, disponível sob a licença Apache 2.0 no GitHub, fornece uma camada de isolamento testada para produção para equipes que desenvolvem agentes de codificação ou de navegação. O SPACE utiliza microVMs Firecracker, com cada sandbox tendo seu próprio kernel de convidado e gateway de rede para aplicar políticas de saída. As credenciais são mantidas fora do convidado, com as credenciais injetadas na camada de rede, oferecendo escopo hierárquico, limites de taxa e registro de auditoria. A plataforma é dividida em quatro componentes: uma API baseada em PostgreSQL, controladores, serviços de trabalho e uma camada de dados. Os serviços de trabalho gerenciam VMs, redes, volumes, modelos e credenciais, com a cópia btrfs para escrever o sistema de arquivos raiz. Os sandboxes podem estar em quatro estados: em execução, pausado, suspenso ou excluído. As implantações do Kubernetes usam pools quentes para criação rápida, enquanto as configurações de nó único usam snapshots básicos. A Perplexity relatou que 100% das sessões de computador são executadas no SPACE, com a latência reduzida de 447 ms para 89 ms. Um relatório de segurança testou nove modelos, encontrando bypasses em quatro, incluindo Claude Opus 5.0 e GPT-5.6 Sol. A Perplex, a empresa, adicionou validação de endereço de origem através do nftables, e testes subsequentes mostraram que não havia bypasses verificados. A equipe também testou dez plataformas de terceiros, com oito mostrando bypasses de política de rede, e divulgou os resultados para os fornecedores afetados.
Itaú expande a IA generativa para atender a base de clientes completa até o final de 2026
A Itaú, o maior banco do Brasil, está utilizando a IA generativa para aprimorar as experiências de clientes e funcionários, através de sua estratégia "AI First". A plataforma ia.i da instituição, uma interface conversacional, visa atender a toda a base de clientes até o final de 2026. Carlos Eduardo Mazzei, o CTO da Itaú, enfatizou a importância da simplicidade e da direta nas soluções de IA, afirmando que a tecnologia deve ser quase imperceptível para os clientes. Um estudo da Itaú e do Grupo Consumoteca revelou que 80% dos brasileiros buscam uma melhor organização financeira, com 65% interessados em assistentes financeiros. A estratégia de IA do banco inclui a plataforma de governança IARA, que gerencia o acesso a diversos modelos, garantindo práticas de IA responsáveis. A IARA suporta soluções como a análise automatizada de documentos do departamento jurídico, processando mais de 2 milhões de tarefas mensalmente, com ganhos de eficiência de 20% a 80%. Mazzei destacou a necessidade de uso seguro e governado de modelos para manter a viabilidade econômica. A plataforma também alimenta o Customer DNA, enriquecendo o contexto financeiro de 70 milhões de clientes, utilizando modelos GPT. A Itaú planeja expandir as capacidades da ia.i, incluindo simulações de produtos e análises financeiras recorrentes, até o final do ano. O banco espera triplicar o tempo de relacionamento com o cliente, dobrar a velocidade do serviço e triplicar a eficácia da conversa. Mazzei enfatizou que a IA deve estar alinhada com os valores do banco, reduzindo o viés e garantindo a relevância cultural nas interações com os clientes.
Elorian lança modelo de IA que interage diretamente com dados visuais
A Elorian, uma startup de IA sediada em Palo Alto, lançou seu primeiro modelo, Glimpse, que permite a interação direta com dados visuais. O modelo, lançado como uma prévia de pesquisa, oferece acesso à API e uma interface de chat, atualmente disponível apenas através de uma lista de espera. O Glimpse permite que a IA revise o material original durante o raciocínio, permitindo que ela recorte imagens, extraia quadros de vídeo ou execute código para análise, uma funcionalidade que a empresa chama de 'espaço de trabalho visual'. Andrew Dai, CEO da Elorian, ex-pesquisador do Google DeepMind, destacou as limitações dos modelos de IA atuais na compreensão de pistas visuais, citando exemplos como jogos de tabuleiro e diagramas da IKEA. Ele observou que, embora os humanos possam interpretar essas visuais com um mínimo de texto, os modelos de IA têm dificuldade em compreender seu significado. No entanto, o Glimpse supera modelos como o GPT-6 Astra em raciocínio sobre gráficos científicos e legendagem de vídeos curtos. A startup, que surgiu do anonimato há seis meses, arrecadou 55 milhões de dólares em financiamento inicial, avaliando a empresa em 300 milhões de dólares. O Glimpse custa 0,60 dólares por milhão de tokens de entrada e 3 dólares por milhão de tokens de saída, posicionando-o entre modelos de nível médio e leves. A Elorian visa desenvolver o 'melhor modelo de raciocínio visual do mundo' até o próximo ano, com foco em setores com grandes conjuntos de dados de vídeo, incluindo robótica e mídia.
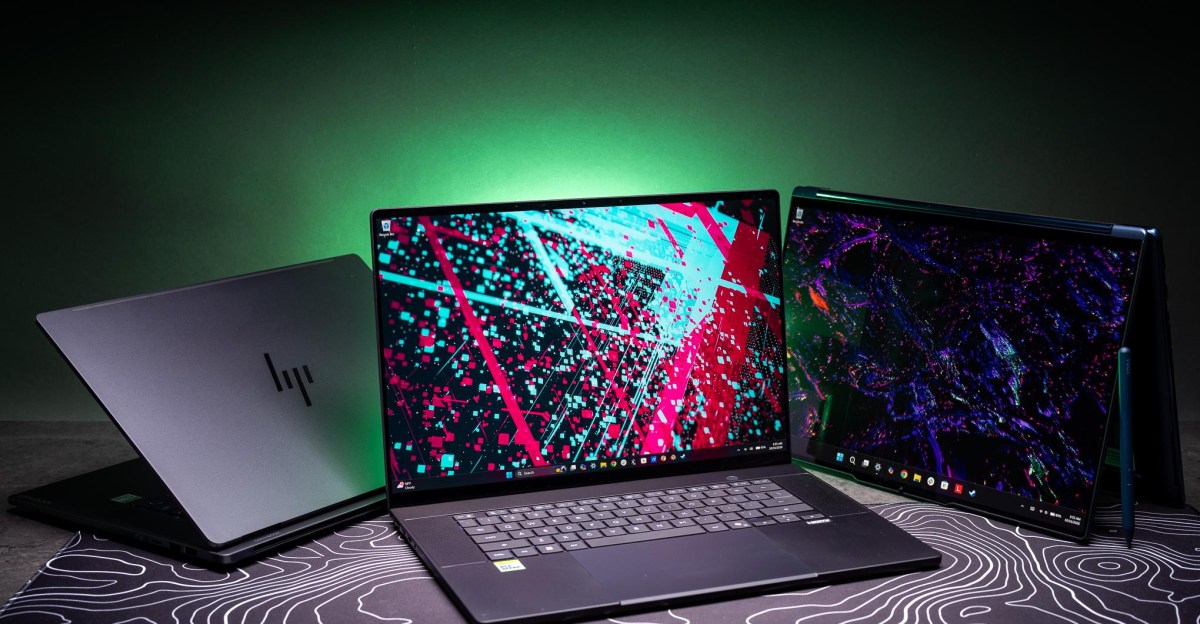
Processador Nvidia rtx spark n1x impulsiona novos laptops, competindo com os principais fabricantes de chips
A Nvidia lançou seu processador RTX Spark N1X, um SoC baseado em Arm de alto desempenho, voltado para laptops e desktops compactos, competindo com as ofertas da Apple, Intel, AMD e Qualcomm. O chip possui inúmeros núcleos, gráficos Nvidia RTX Blackwell e memória unificada suficiente para executar modelos de IA locais de grande porte. O dispositivo de destaque é o Microsoft Surface Laptop Ultra, equipado com 128 GB de memória unificada, avaliado por Tom Warren. Sean Hollister está testando uma versão de 64 GB do modelo Asus. The Verge fornece mais detalhes sobre o desempenho e as capacidades desses novos laptops, destacando os avanços da Nvidia no mercado de processadores para laptops. A RTX Spark N1X representa um passo significativo na expansão da Nvidia nos mercados de laptops e desktops, aproveitando sua experiência em gráficos e IA. Com sua combinação de gráficos poderosos e memória unificada, o processador está posicionado para desafiar os líderes existentes na indústria. O Surface Laptop Ultra e as variantes Asus são alguns dos primeiros dispositivos a demonstrar o potencial dessa nova tecnologia, oferecendo aos usuários desempenho e capacidades aprimoradas para executar modelos de IA complexos localmente. A cobertura da The Verge fornece uma análise aprofundada do desempenho e dos recursos desses dispositivos, destacando a crescente influência da Nvidia no espaço da computação.
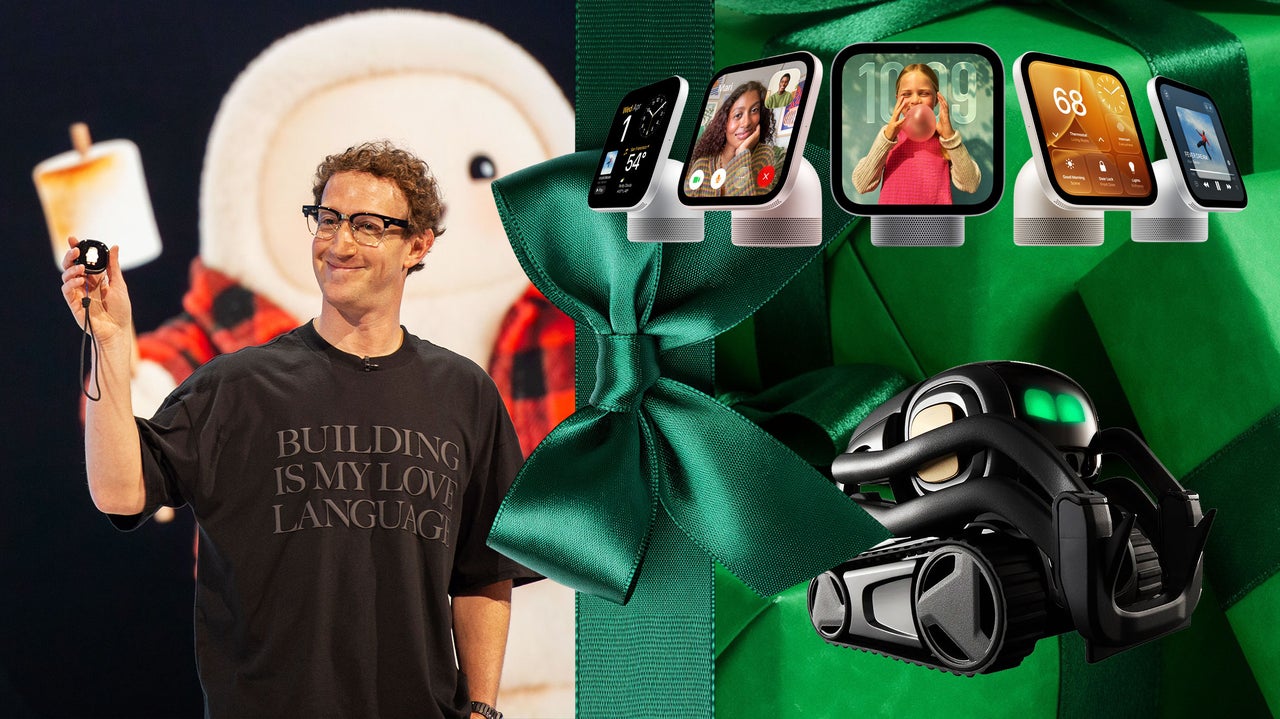
Conjunto de brinquedos e dispositivos de IA pronto para transformar a temporada de férias
A temporada de férias de 2026 deverá apresentar uma ampla gama de dispositivos de IA para crianças e adultos, com grandes empresas de tecnologia lançando novos produtos. A Apple lançou o HomeView, um dispositivo doméstico inteligente alimentado pela Siri aprimorada por IA, permitindo que os usuários controlem campainhas, termostatos e fechaduras. A Amazon introduziu novos tablets Alexa executando Alexa+, com preços variando de US$ 229 a US$ 500. A Microsoft está prestes a lançar o Surface Laptop Ultra, equipado com um chip de IA da Nvidia, com preço de US$ 2.599, com início das remessas em 16 de outubro. A Meta está expandindo suas ofertas de IA com o Muse Charm, um chaveiro semelhante ao Tamagotchi, e uma nova linha de óculos aprimorados por IA, incluindo modelos sem câmeras, para abordar preocupações com privacidade. A empresa planeja oferecer 100 modelos diferentes de óculos de IA até o final do ano. Essas desenvolvimentos destacam a crescente integração da IA na vida cotidiana durante a temporada de férias. A Meta também introduziu uma versão do Windows de seu agente de IA Muse, visando aproveitar sua popularidade na App Store da Apple. A empresa tem planos ambiciosos para seu Muse Charm, que pode gerenciar tarefas como organização de caixa de entrada e reservas de jantar. Com brinquedos de IA já disponíveis no mercado e um aumento nos dispositivos de IA, a temporada de férias está se tornando um marco significativo na adoção da tecnologia de IA.
Tencent apresenta estrutura de memória de código aberto para agentes de IA
A Tencent lançou o Hy Memory 2.0, uma estrutura de memória de código aberto para agentes de IA, juntamente com um modelo dedicado e a aplicação MemHub. A estrutura suporta a memória de chat, trabalho e código, permitindo que os desenvolvedores a integrem em seus agentes. O Hy Memory 2.0 superou vários frameworks existentes em testes de referência, obtendo pontuações de destaque nas áreas de memória e benchmarks de código. A Tencent afirma que é a primeira a introduzir a memória de trabalho e código em uma estrutura de memória. O modelo Hy-Memory-30A3B, treinado em vários frameworks, superou o Claude Opus 5 em desempenho. A MemHub, uma ferramenta de gerenciamento de memória local, permite que os usuários sincronizem conversas entre várias ferramentas de IA. O SDK e os pesos do modelo estão agora disponíveis no GitHub e no Hugging Face, respetivamente. A Tencent planeia refinar ainda mais as capacidades de memória em aplicações do mundo real.
Liquid AI supera o modelo jev 1.14 da typesafe AI com o modelo d1-ultra
A TypeSafe AI apresentou o seu modelo de decisão Jev 1.14 em 14 de outubro de 2026, no horário do Pacífico, introduzindo funcionalidades como a entrada de imagens e um novo tipo 'caixa'. O modelo suporta um contexto alargado, até 262.000 tokens. Apenas um dia depois, a Liquid AI anunciou o seu modelo d1-ultra, afirmando que este supera o Jev 1.14 em oito tarefas. O d1-ultra também supera o vLLM Semantic Router d3 em desempenho geral. O modelo da Liquid AI é posicionado como o 'melhor do mundo', estabelecendo um novo padrão nas capacidades de tomada de decisões. A rápida resposta da Liquid AI destaca o ritmo competitivo no desenvolvimento de IA, com avanços significativos no desempenho e na funcionalidade dos modelos.